Att välja rätt edge Computing en arkitektur för distribuerade platser kräver noggrann justering av tekniska möjligheter, affärsmål och infrastrukturbegränsningar. När organisationer expanderar verksamheten till flera platser har efterfrågan på realtidsbearbetning, minskad latens och lokal intelligens aldrig varit större. Ditt val av arkitektur kommer direkt att påverka operativ effektivitet, datasäkerhet och förmågan att svara på IoT-händelser med minimal fördröjning.
Det grundläggande beslutet vid införandet av edge computing-lösningar bygger på att förstå var bearbetning bör ske – på fjärrplatser, i regionala nav eller via en hybridmodell. Den här guiden går igenom de avgörande utvalgsfaktorerna, från latenskrav och IoT-sensortäthet till nätverkets tillförlitlighet och den beräkningskraft som krävs på varje distribuerad plats. Fram till 2026 kommer sannolikt mönstren för edge computing-distribution att förskjutas mot mer sofistikerade, AI-drivna arkitekturer, vilket gör det avgörande att bygga ramverk som är tillräckligt flexibla för att utvecklas.
Latens är den främsta drivkraften bakom beslut om edge computing för distribuerade platser. När IoT-sensorer genererar tidskritiska data – till exempel övervakning av maskinernas hälsa, videobehandling eller signaler för autonom styrning – kan även millisekunder av fördröjning påverka säkerheten, kvaliteten eller användarupplevelsen negativt. Utvärdera latensgränsen för varje programarbetsbelastning: särskilt kritiska processer kan kräva svarstider under 100 millisekunder, medan analys och rapportering kan tolerera fördröjningar på flera sekunder.
Din edge computing-arkitektur måste behandla data där de uppstår, snarare än att skicka rådataströmmar till en central molntjänst. Detta minskar bandbredden för backhaul, förhindrar nätverksbelastning och säkerställer konsekvent prestanda även om internetanslutningen blir opålitlig. Dokumentera den maximalt acceptabla latensen för varje distribuerad plats primära användningsfall, och utforma sedan placeringen av beräkningsresurser och dataflödet därefter. Applikationer som involverar realtids-IoT-automatisering, förutsägande underhåll eller säkerhetskritiska beslut drar vanligtvis störst nytta av lokal edge-behandling.
Skalan och typen av IoT-enheter på varje distribuerad plats avgör den beräknings- och lagringskapacitet som din edge-computing-lösning måste erbjuda. IoT-miljöer med hög densitet – till exempel tillverkningsgolv med hundratals sensorer, smarta byggnadssystem eller fjärrövervakningsnätverk – genererar kontinuerliga dataströmmar som överväldigar centraliserad molnbehandling och förbrukar för stora bandbreddsmängder. Inventerar antalet IoT-sensorer, datafrekvensen och nyttolastens storlek per plats för att fastställa grundläggande bearbetningskrav.
Överväg inte bara nuvarande sensorkapacitet utan även den förväntade tillväxten fram till år 2026. Organisationer som inför IoT-funktioner eller utökar automatiseringen på sina anläggningar behöver arkitekturer som skalar smidigt. Att förutse edge-computing-kapacitet för framtida IoT-tillväxt minskar kostsamma omdesigner och störningar vid migrering. Arkitekturen för distribuerade platser bör modularisera beräkningsresurser så att ytterligare bearbetningsenheter integreras sömlöst när IoT-densiteten ökar.
Tre primära arkitekturmönster för edge computing används för distribuerade platser, var och en med olika avvägningar. En centraliserad edge-modell koncentrerar beräkningskapacitet till ett litet antal regionala nav, vilket minskar driftskomplexiteten och investeringen i hårdvara, men introducerar backhaul-latenstid och potentiella enskilda felkällor. Detta tillvägagångssätt är lämpligt för organisationer med förutsägbara trafikmönster och arbetsbelastningar som inte är särskilt tidskritiska. Å andra sidan placerar fullständigt distribuerad edge computing beräkningsresurser på varje fjärrplats, vilket garanterar minimal latens och maximal återhämtning, men samtidigt ökar komplexiteten kring hantering, underhåll och licensiering över dussintals eller hundratals platser.
De mest mogna distributionerna använder en hybridmodell för edge-computing som stratifierar bearbetningen: uppgifter som kräver låg latens utförs på plats med hjälp av lättviktiga beräkningsresurser, medan resurskrävande analys och långsiktig lagring utnyttjar regionala eller molnbaserade anläggningar. Detta balanserade tillvägagångssätt utnyttjar fördelarna med edge-computing där latensen är viktigast, samtidigt som driftsoverhead begränsas. Hybriddesigner passar väl för IoT-arbetsbelastningar som kombinerar realtidsensorfusion med batchanalys. Utvärdera din arbetsbelastningsmix, IT-personalens begränsningar och ditt budgetanslag för att fastställa den rätta placeringen för dina distribuerade platser.
Nätverkstopologin påverkar prestanda och motståndskraft för edge computing i distribuerade miljöer. Om alla edge computing-noder på fjärrplatser måste kommunicera via en enda uplink till en central hanteringsnod riskerar man flaskhalsar och kedjefel. Implementera lokalnätverkskluster där edge computing-noder kan samarbeta med grannar innan de skickar sammanfattade insikter uppströms. Denna design minskar bandbredden på backbone-nätverket, förbättrar felisolering och ökar motståndskraften vid bortfall av anslutning.
År 2026 kommer arkitekter för edgeberäkning alltmer att inkludera mesh-nätverk, där distribuerade platser upprättar direkta peer-to-peer-anslutningar parallellt med molnupplänkningar. Mesh-topologier distribuerar bearbetningsintelligens över nätverket och gör det möjligt för platser att behålla delvis autonomi under avbrott i växelanslutna nätverk. Utvärdera din distribuerade verksamhets geografiska spridning, anslutningspålitlighet och krav på samarbete mellan platser vid val av topologi. Verksamheter med hög säkerhetsnivå eller avlägsna platser drar särskilt stora fördelar av edgeberäkningsdistributioner med mesh-funktion.
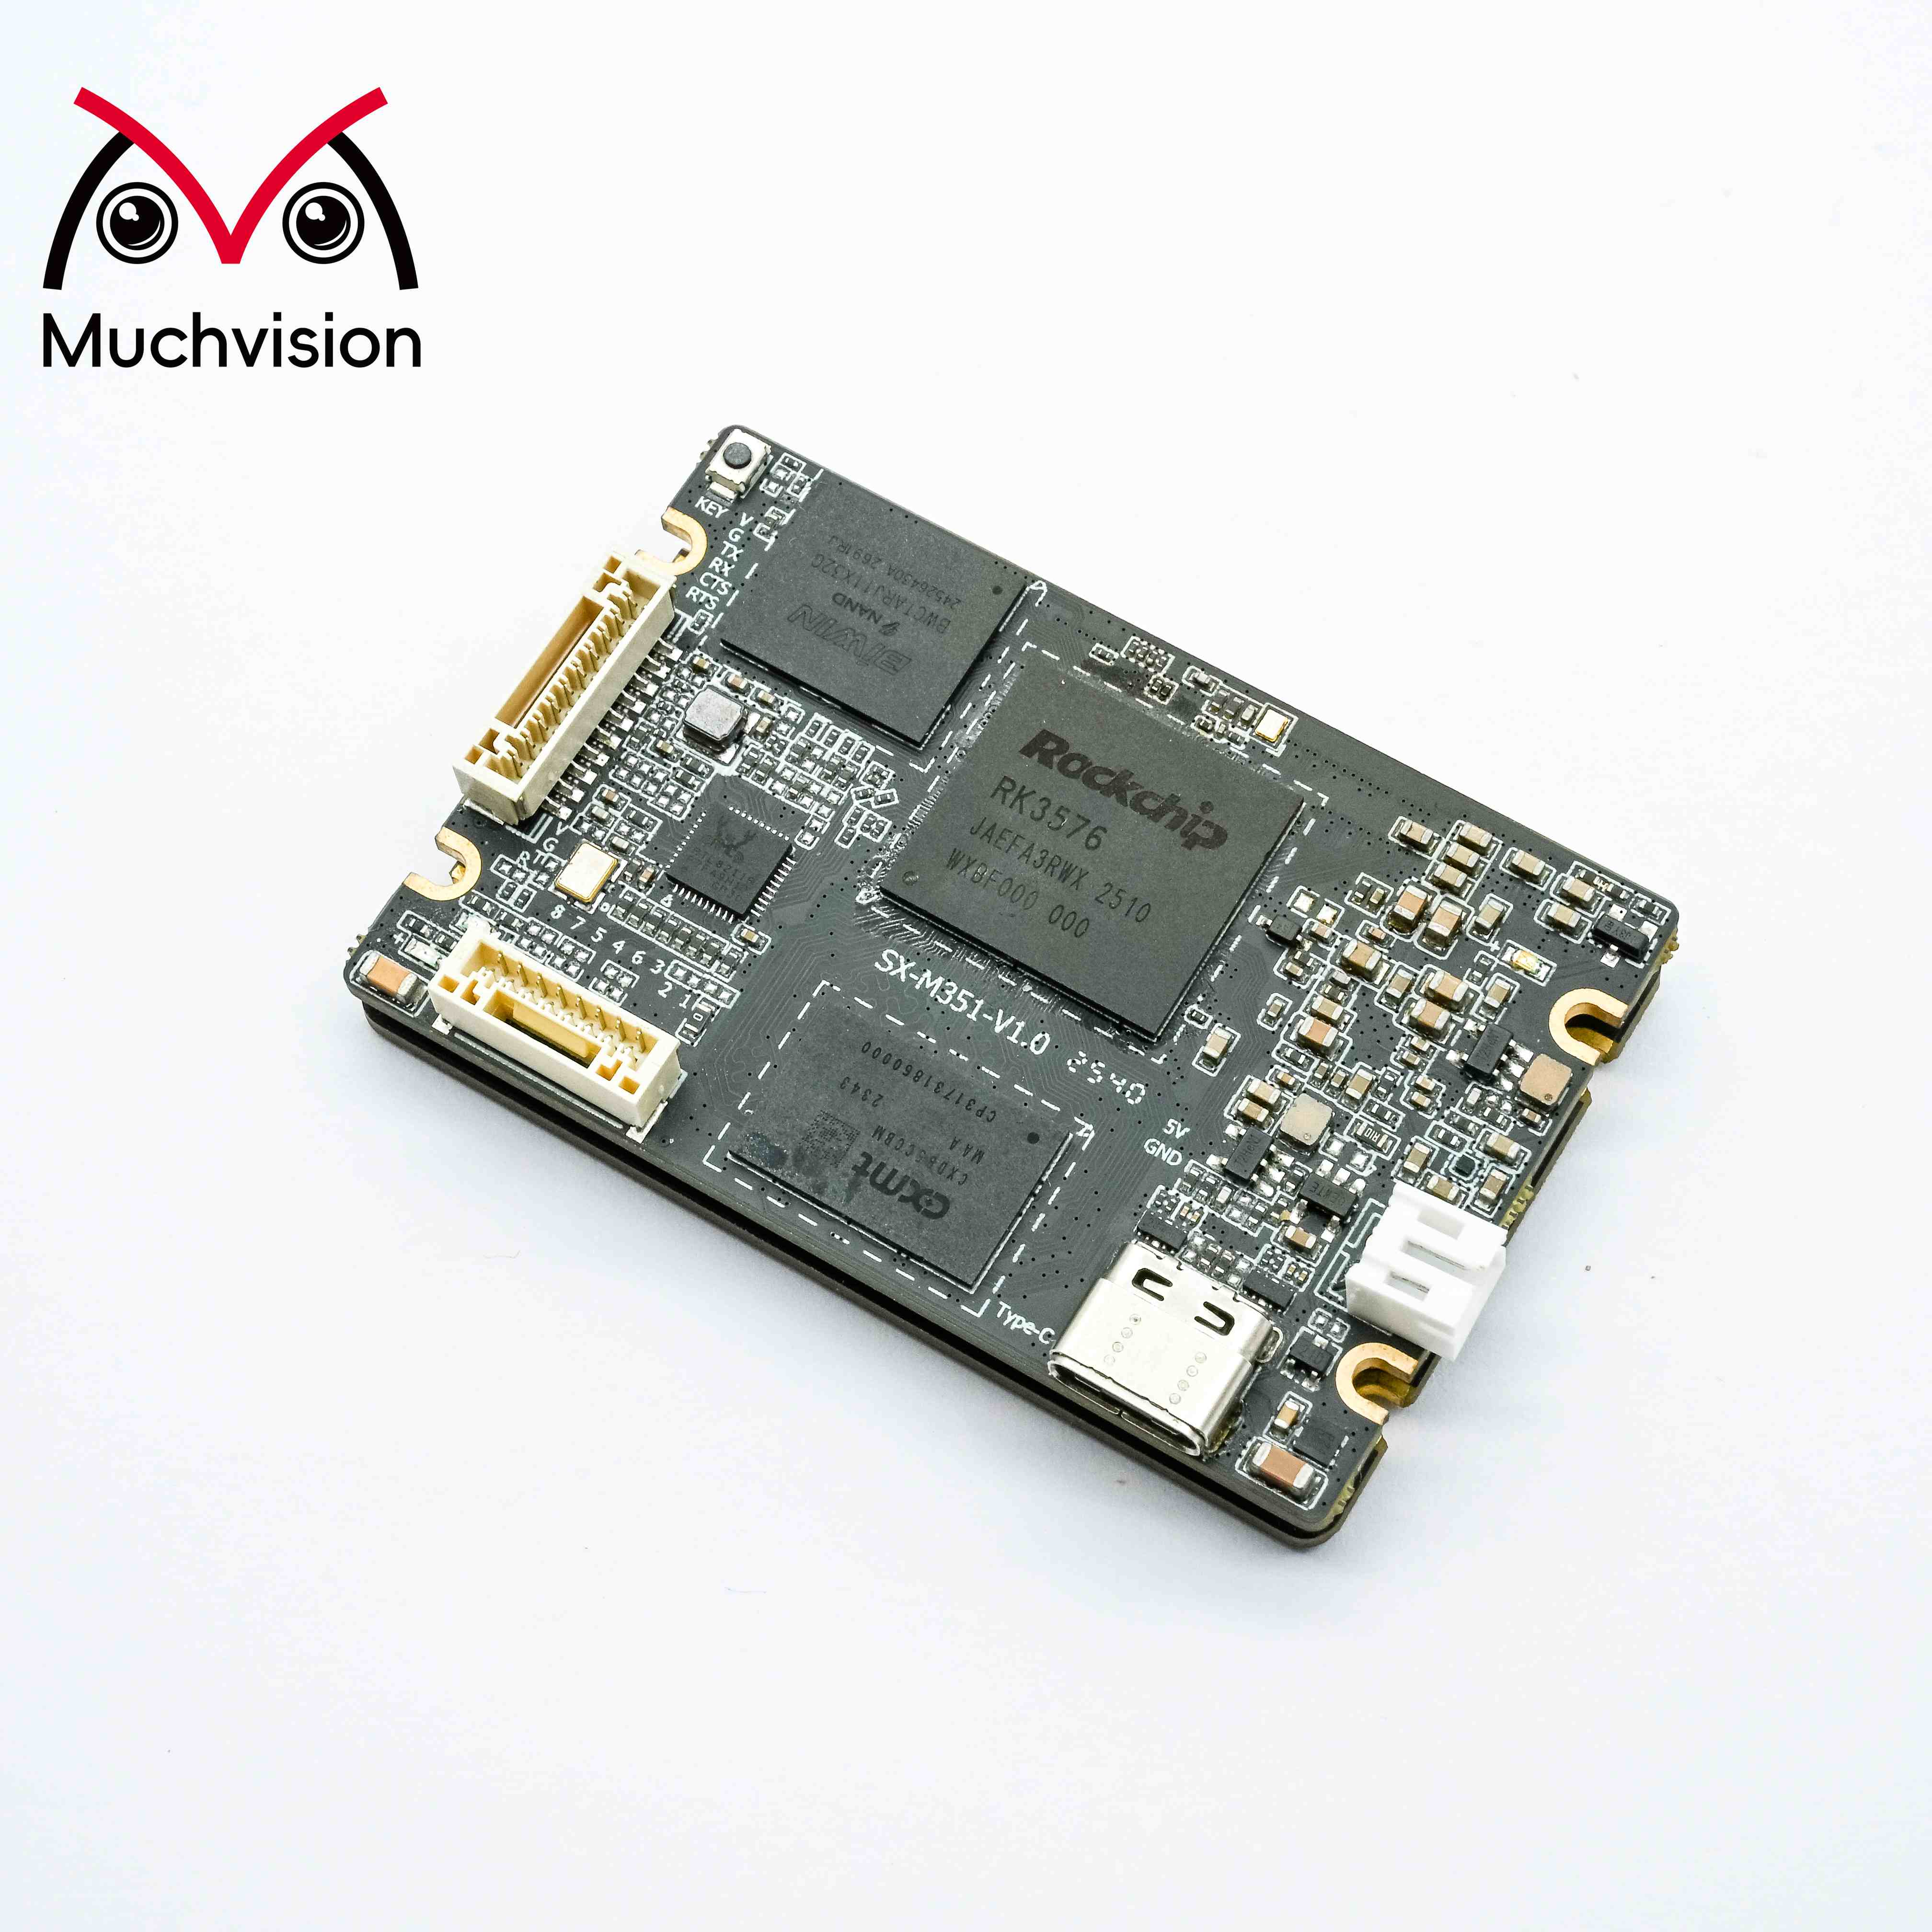
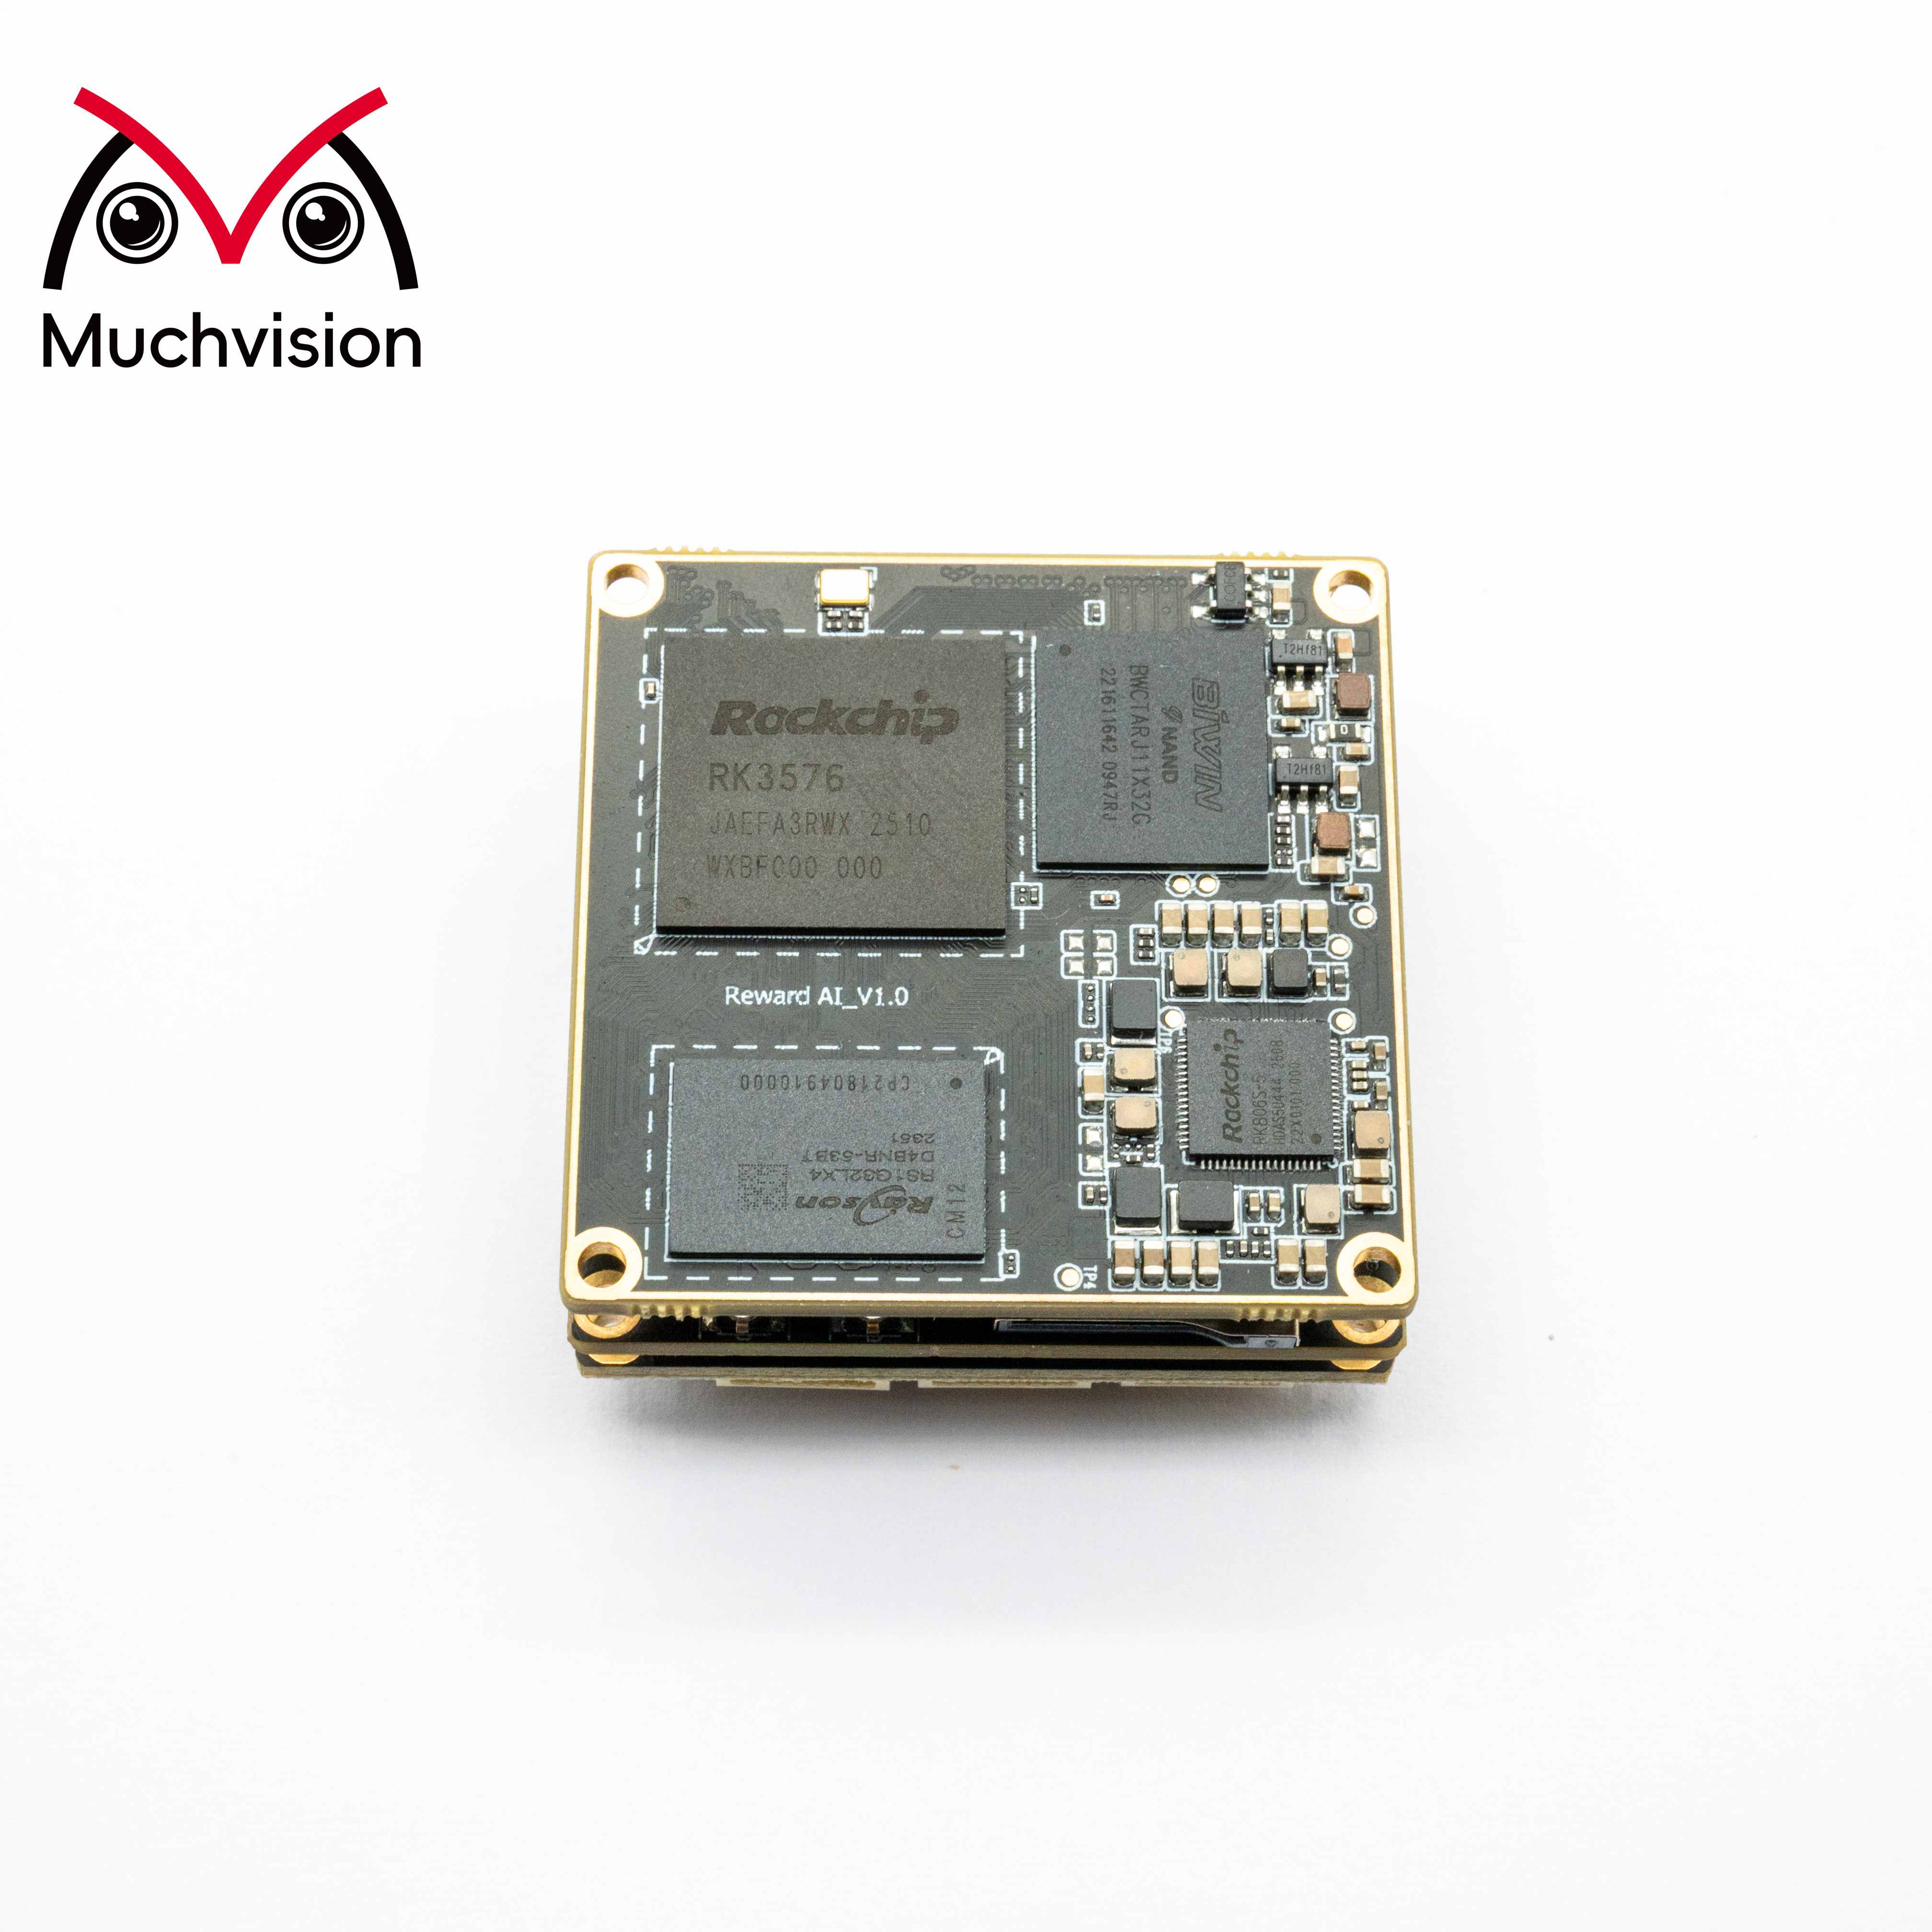
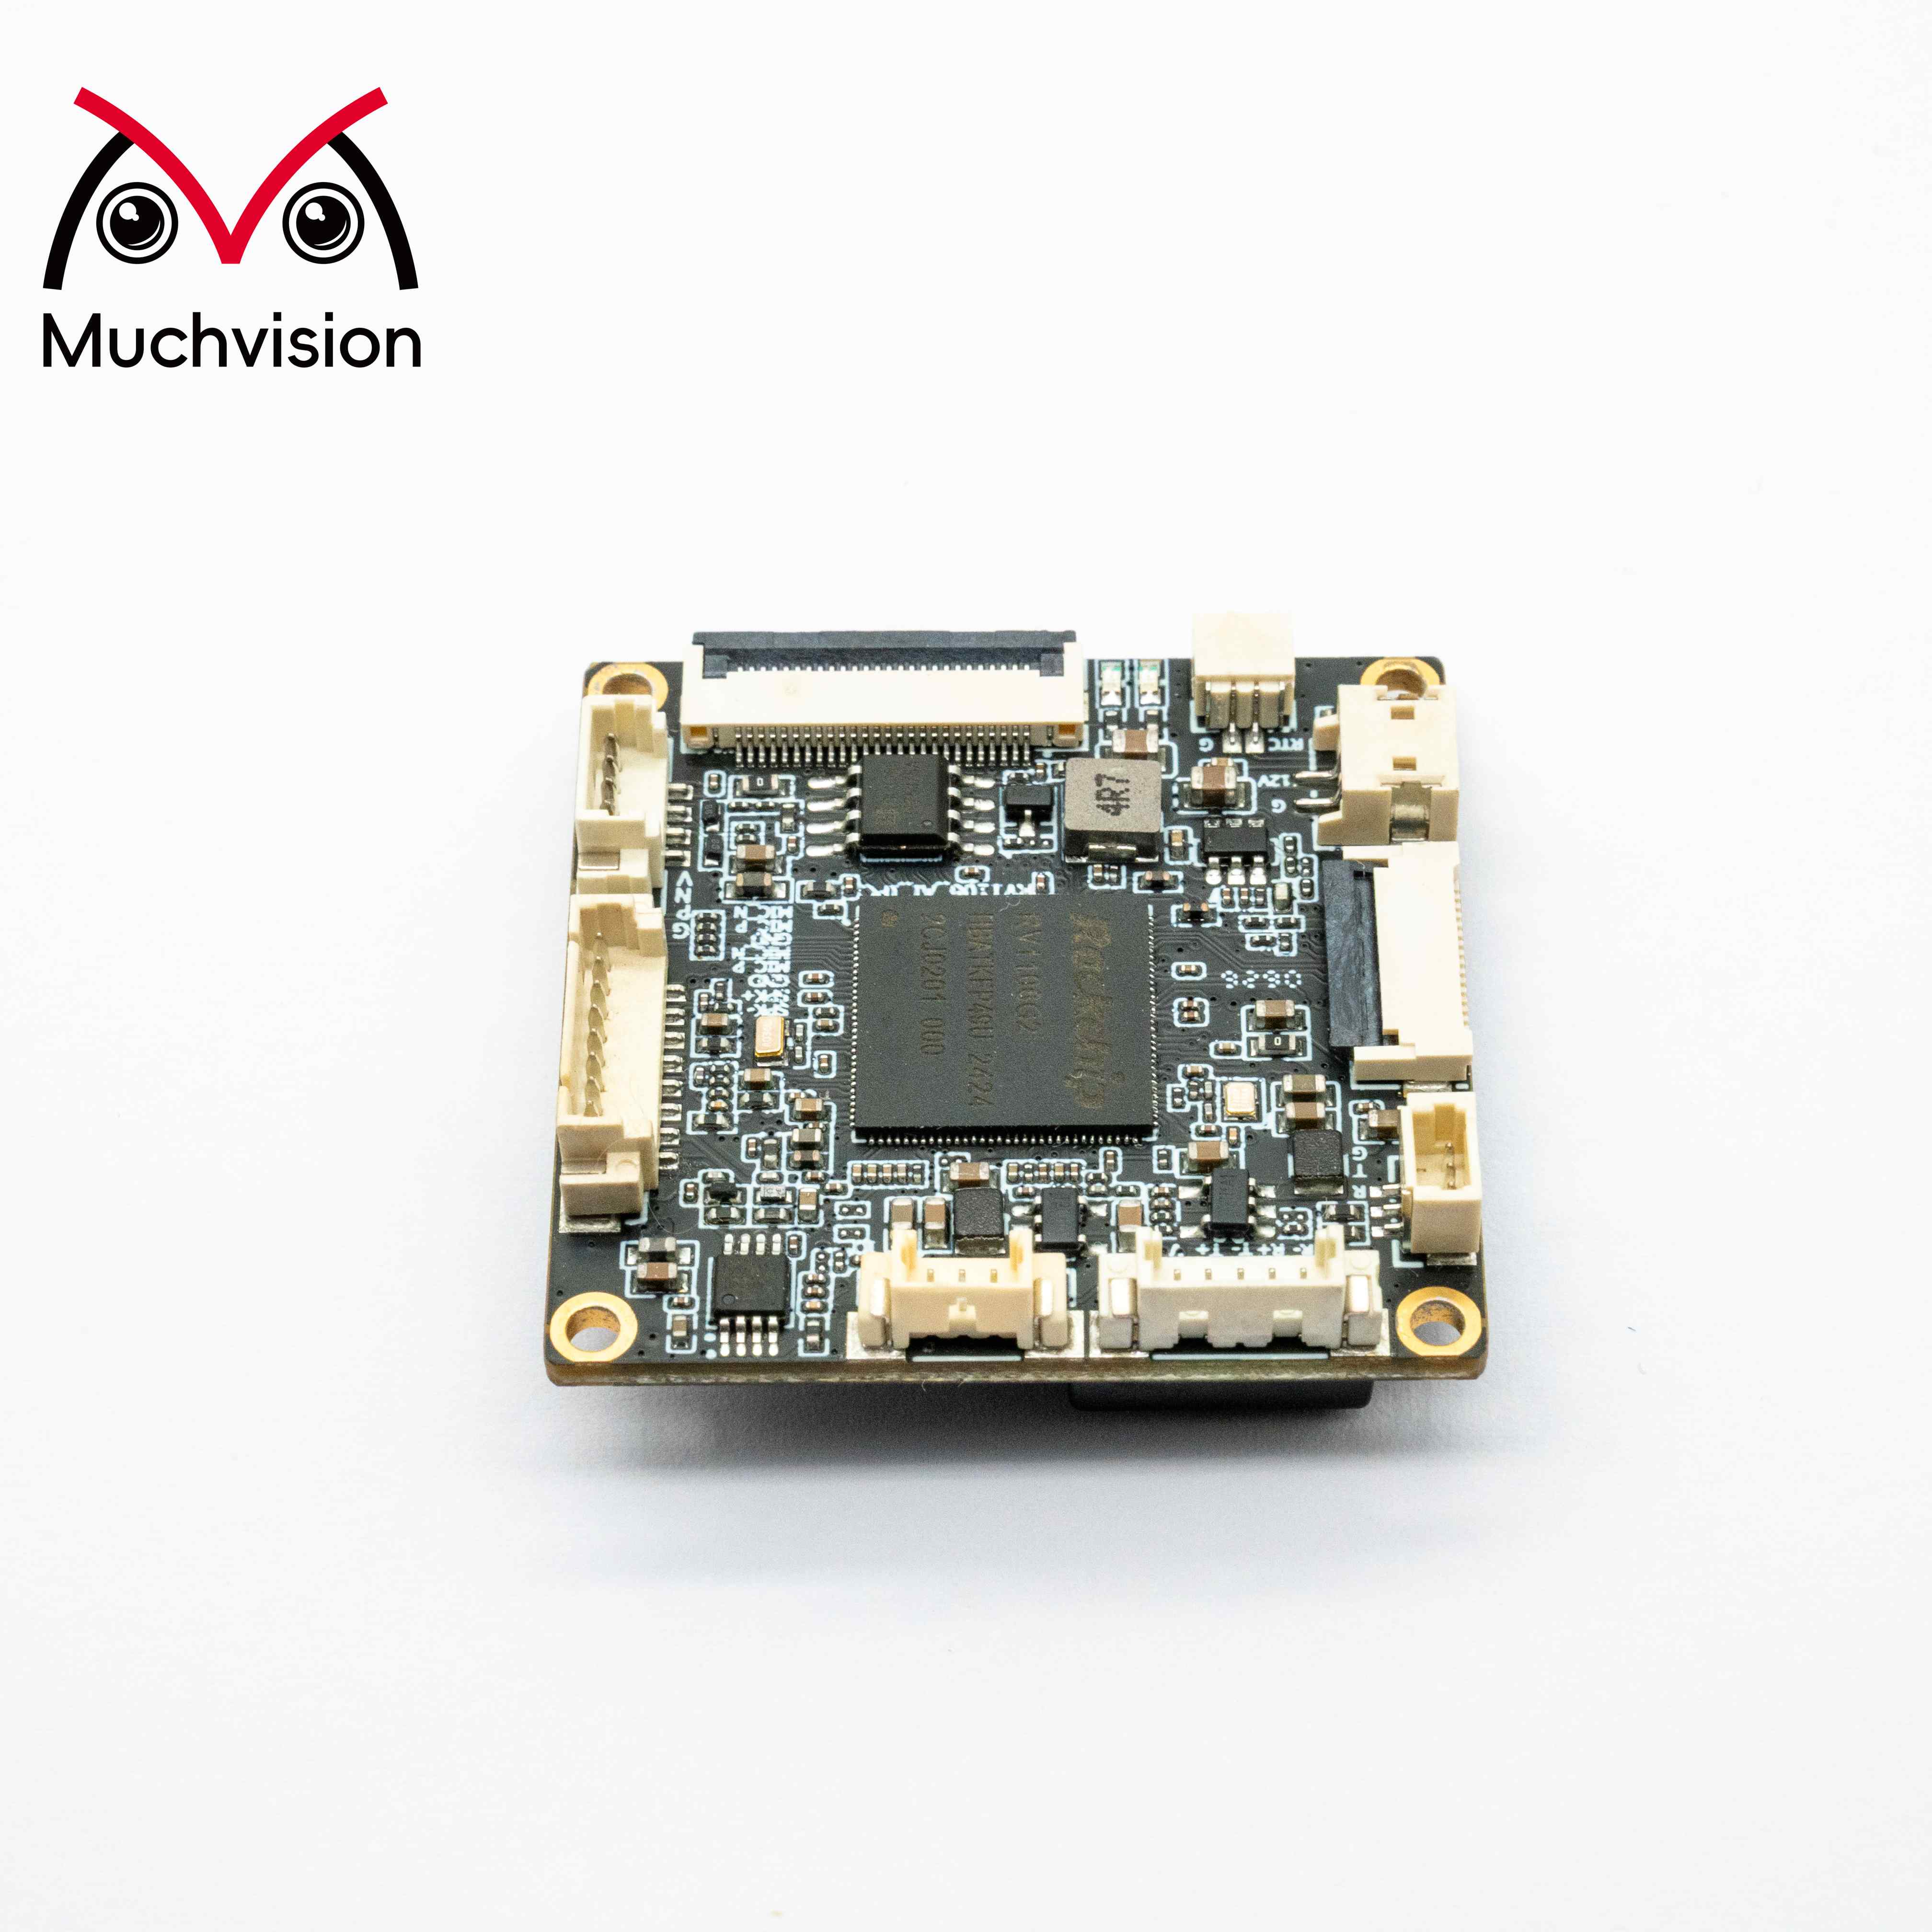
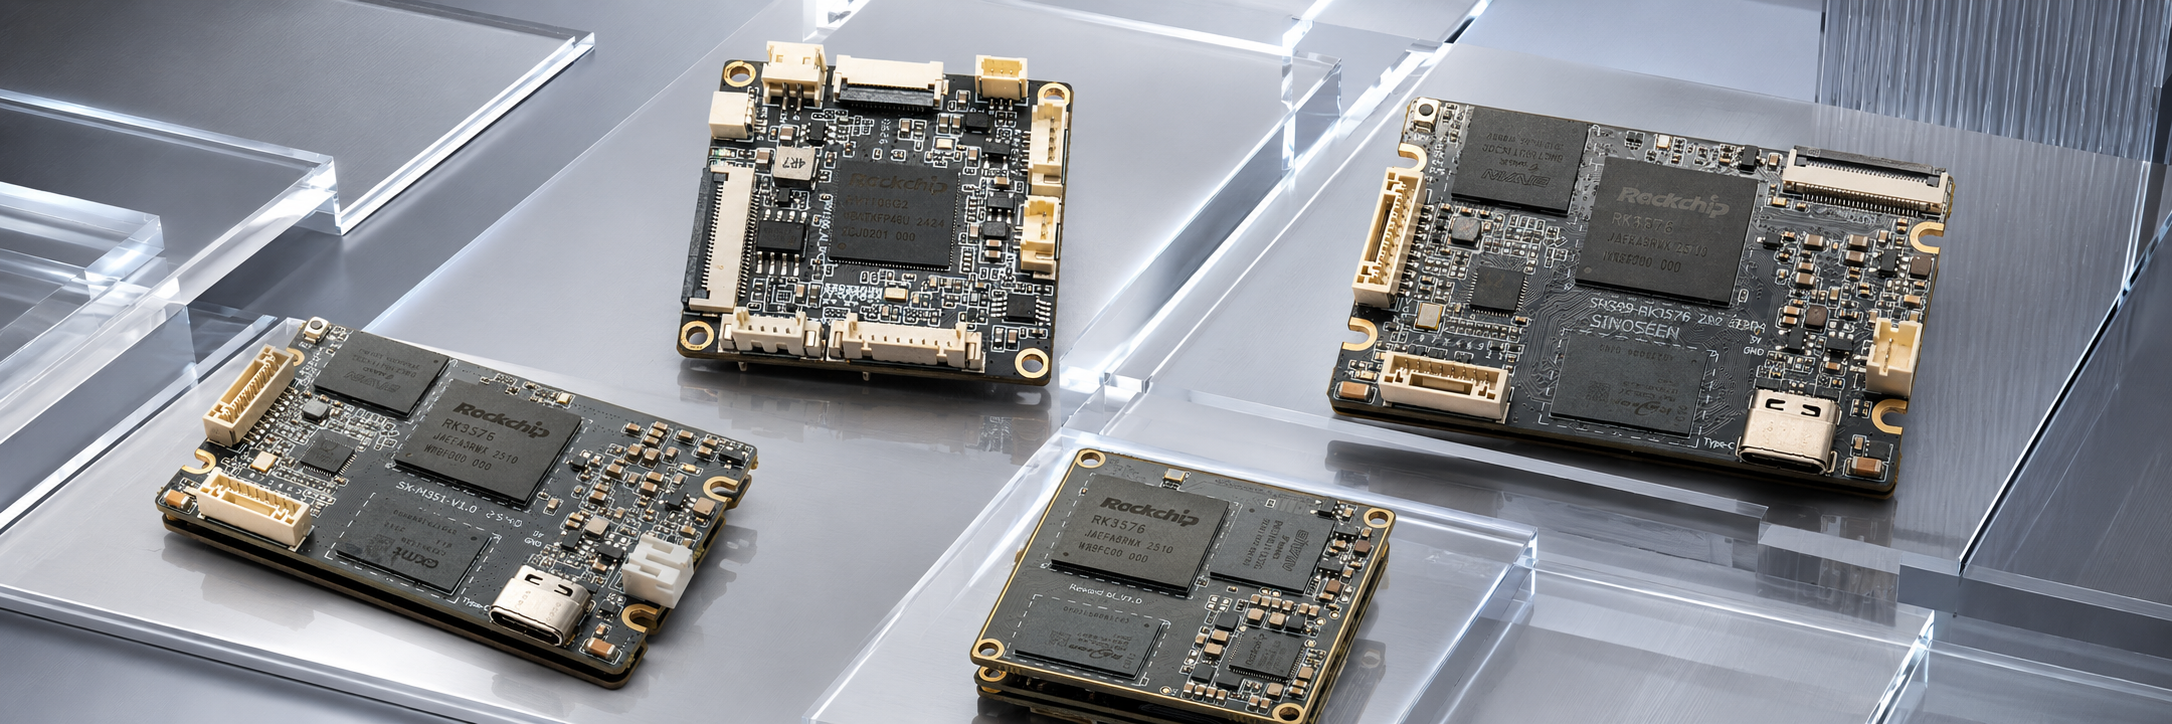
Edgeberäkningsmaskinvara sträcker sig från robusta IoT-gateways som förbrukar watt till fläktlösa industriella datorer som kör fullständiga Kubernetes-kluster. För distribuerade platser med måttliga arbetsbelastningar erbjuder edgeberäkningslösningar baserade på ARM-processorer eller kompakta x86-kort energieffektivitet och termisk enkelhet, vilket är avgörande i utmanande miljöer. För tunga beräkningsuppgifter eller AI-inferensarbetsbelastningar ger robusta edgeberäkningsserver med dedicerade GPU:er eller neurala accelererare den nödvändiga prestandan. Behållarvirtualisering med Docker och Kubernetes möjliggör konsekvent programvarudistribution över heterogen edgeberäkningsinfrastruktur på olika platser, vilket förenklar uppdateringar och versionshantering.
Val av programvara för edgeberäkning måste balansera funktionsrikedom mot resursbegränsningar. Lättviktiga Linuxdistributioner och minimala containerkörningsmiljöer bevarar bearbetningskapacitet för applikationer. Sök efter edgeberäkningsplattformar som stödjer både moln-nativa verktyg och traditionella industriella protokoll för att koppla samman äldre IoT-distributioner med moderna arbetsbelastningar. Er strategi för edgeberäkning 2026 bör kunna hantera framväxande AI-ramverk, realtidsdatabaser och säkerhetsstandarder utan att kräva ombyggnad av arkitekturen.
Distribuerade edge-computing-stationer ökar din säkerhetsytas storlek, vilket kräver robust autentisering, kryptering och avvikelsedetektering vid varje nod. Inför certifikatbaserad autentisering för edge-computing-enheter som kommunicerar med centrala system, och tvinga på kryptografisk signering av programvaruuppdateringar som distribueras till fjärrplatser. Lagring och behandling av känslig data vid edge-computing-noder – särskilt i industriella IoT-sammanhang – kräver noggranna åtkomstkontroller och granskningsloggning.
Driftövervakning av edge computing-distributioner på många platser kräver automatisering och intelligens. Centraliserade instrumentpaneler som visar hälsotillstånd, prestandamått och latens från varje distribuerad plats möjliggör snabb felidentifiering. Överväg edge computing-plattformar som erbjuder zero-touch-provisioning, automatisk enhetsupptäckt och pushbaserade programvaruuppdateringar för att minimera IT-arbetet på plats. Fram till 2026 kan du förvänta dig att edge computing-hanteringverktyg integrerar AI-drivna anomalidetekterings- och självläkande funktioner, vilket gör storskaliga distribuerade distributioner mer hållbara.
Edgeberäkning uppnår vanligtvis svarstider på 1–50 millisekunder för lokal bearbetning, jämfört med 50–500+ millisekunder för moln-baserade rundresor. Den faktiska svarstiden beror på avståndet mellan dina IoT-sensorer och edge-enheter, bearbetningskomplexiteten och nätverkskvaliteten. Välutformade edgeberäkningsarkitekturer för distribuerade platser minimerar variabiliteten och garanterar deterministiska svarstider för kritiska arbetsbelastningar, vilket gör svarstiden förutsägbar snarare än bara låg.
Antalet noder beror på geografisk spridning, IoT-täthet, redundanskrav och önskad svarstid. En praktisk regel är att placera edgeberäkningsnoder nära IoT-datakällorna för att minimera antalet hopp mellan sensorer och edge, och sedan gruppera edgeberäkningsnoder regionalt där anslutning och administrativ effektivitet tillåter. Börja med en edgeberäkningsnod per större plats eller per 50–100 IoT-enheter, och expandera sedan baserat på uppmätt prestanda och tillgänglighetsmål.
Standarder för edge computing, AI-acceleration och säkerhetspraktiker utvecklas snabbt. Bygg in designflexibilitet i din distribuerade platsarkitektur genom att använda containeriserade arbetsbelastningar, modulär hårdvara och hanteringsskikt med API som primär gränssnitt. Senast år 2026 kommer många organisationer att integrera stora språkmodeller (LLM) och realtidsbaserad AI-resonemang i sina edge computing-noder – se därför till att din arkitektur stödjer programvaruuppdateringar och GPU-acceleration utan fysisk omkonstruktion.
 Senaste nytt
2026-11-06
2026-10-29
2026-10-24
2026-10-23
2026-10-20
2026-10-19

 EN