Velg den rette edge-beregning en arkitektur for distribuerte nettsteder krever nøye avstemming av tekniske evner, forretningsmål og infrastrukturkrav. Ettersom organisasjoner utvider driften sin til flere lokasjoner, har behovet for sanntidsbehandling, redusert forsinkelse og lokal intelligens aldri vært større. Valget av arkitektur vil direkte påvirke driftseffektiviteten, datasikkerheten og evnen til å reagere på IoT-hendelser med minimal forsinkelse.
Den grunnleggende avgjørelsen ved implementering av edge computing-løsninger avhenger av å forstå hvor behandlingen bør finne sted – på fjerne nettsteder, i regionale sentra eller gjennom en hybridmodell. Denne veiledningen fører deg gjennom de kritiske valgfaktorene, fra latenstilbehov og IoT-sensor-tetthet til nettverkspålitelighet og beregningskraft som kreves på hvert distribuerte sted. Ved 2026 vil sannsynligvis mønsteret for implementering av edge computing skifte mot mer sofistikerte, AI-drevne arkitekturer, noe som gjør det avgjørende å bygge rammeverk som er fleksible nok til å utvikle seg.
Latens er den viktigste årsaken til beslutninger om kantdataprogrammering for distribuerte nettsteder. Når IoT-sensorer genererer tidskritiske data – som overvåking av maskinens helse, videovurderinger eller signaler for autonom kontroll – kan selv millisekunder med forsinkelse påvirke sikkerheten, kvaliteten eller brukeropplevelsen negativt. Vurder toleransen for latens i hver enkelt programbelastning: prosesser som er livsviktige krever kanskje svar innen under 100 millisekunder, mens analyse- og rapporteringsoppgaver kan tåle forsinkelser på flere sekunder.
Din edge computing-arkitektur må behandle data der de oppstår, i stedet for å sende rådatastrømmer til en sentral skyinfrastruktur. Dette reduserer bakoverbindelsesbåndbredden, hindrer nettverksforstoppelse og sikrer konstant ytelse, selv når internetttilkoblingen blir ustabil. Dokumenter den maksimale akseptable latenstiden for hvert distribuerte steds primære bruksområder, og utform deretter plasseringen av beregningsressurser og dataflyten i henhold til dette. Applikasjoner som involverer sanntids-IoT-automatisering, prediktiv vedlikehold eller sikkerhetskritiske beslutninger drar vanligvis mest nytte av lokal edge-behandling.
Skalaen og typen av IoT-enheter på hver distribuert sted avgjør den beregnings- og lagringskapasiteten som din edge-computing-løsning må levere. IoT-miljøer med høy tetthet – for eksempel produksjonsanlegg med hundrevis av sensorer, intelligente byggsystemer eller fjernovervåkningsnettverk – genererer kontinuerlige datastrømmer som overbelaster sentralisert skyprosessering og bruker uforholdsmessig mye båndbredde. Registrer antallet IoT-sensorer, datafrekvensen og størrelsen på datalasten per sted for å fastsette grunnleggende prosesseringsbehov.
Vurder ikke bare gjeldende sensorkapasitet, men også forventet vekst fram til 2026. Organisasjoner som legger til IoT-funksjonalitet eller utvider automatiseringen på sine anlegg trenger arkitekturer som skalerer smidig. Å forhåndskonfigurere edge-computing-kapasitet for fremtidig IoT-vekst reduserer kostbare ombygginger og forstyrrelser under migrering. Arkitekturer for distribuerte steder bør modularisere beregningsressurser slik at ekstra prosesseringsenheter integreres sømløst når IoT-tettheten øker.
Tre hovedmønstre for distribuert databehandling (edge computing) støtter distribuerte nettsteder, hver med egne kompromisser. Et sentralisert edge-mønster konsentrerer databehandlingskraften i et lite antall regionale noder, noe som reduserer operasjonell kompleksitet og investeringer i maskinvare, men som også fører til økt backhaul-latenstid og potensielle enkelpunktsfeil. Denne tilnærmingen passer organisasjoner med forutsigbare trafikkmønstre og arbeidsbelastninger som ikke er strengt tidskritiske. Omvendt plasserer fullt distribuert edge-computing databehandlingsressurser på hvert fjernt sted, noe som garanterer minimal latens og maksimal robusthet, men som samtidig øker kompleksiteten knyttet til drift, vedlikehold og lisensiering over dusinvis eller hundretalls lokasjoner.
De mest modne implementeringene bruker en hybrid edge-computing-modell som stratifiserer behandlingen: oppgaver som krever lav forsinkelse utføres på stedet ved hjelp av lettvektsdatamaskiner, mens ressurskrevende analyser og langsiktig lagring utnytter regionale eller skybaserte fasiliteter. Denne balanserte tilnærmingen utnytter fordelene med edge computing der forsinkelse er viktigst, samtidig som driftsbelastningen holdes under kontroll. Hybridarkitekturer passer godt til IoT-arbeidsmengder som kombinerer sanntidsensorfusjon med batchanalyser. Vurder din arbeidsmengdemiks, IT-personalbegrensninger og budsjett for å bestemme den riktige plasseringen for dine distribuerte nettsteder.
Nettverkstopologi påvirker ytelsen og robustheten til kantdataprogramvare i distribuerte miljøer. Hvis alle kantdataprogramvarenodene på fjerne steder må kommunisere gjennom én enkelt oppkobling til en sentral administrasjonssentral, risikerer du flaskehalser og kjedeverkfeil. Implementer lokalnettverksklystring der kantdataprogramvarenoder kan samarbeide med nabonoder før de sender aggregerte innsikter oppstrøms. Denne designløsningen reduserer belastningen på backbone-nettverket, forbedrer feilisolering og øker robustheten ved tap av tilkobling.
I 2026 vil arkitekturer for kantdataprogrammering økende inkludere nettverk i rutenetttopologi, der distribuerte nettsteder opprettholder direkte lik-til-lik-forbindelser ved siden av tilkoblinger til skyen. Rutenetttopologier fordeler behandlingsintelligens over nettverket og gir nettsteder mulighet til å opprettholde delvis autonomi under avbrudd i det vidt utstrakte nettverket. Vurder geografisk spredning, pålitelighet til forbindelser og krav til samarbeid mellom nettsteder når du velger topologi. Oppgavekritiske eller fjerne lokasjoner drar særlig nytte av kantdataprogrammeringsløsninger som støtter rutenetttopologi.
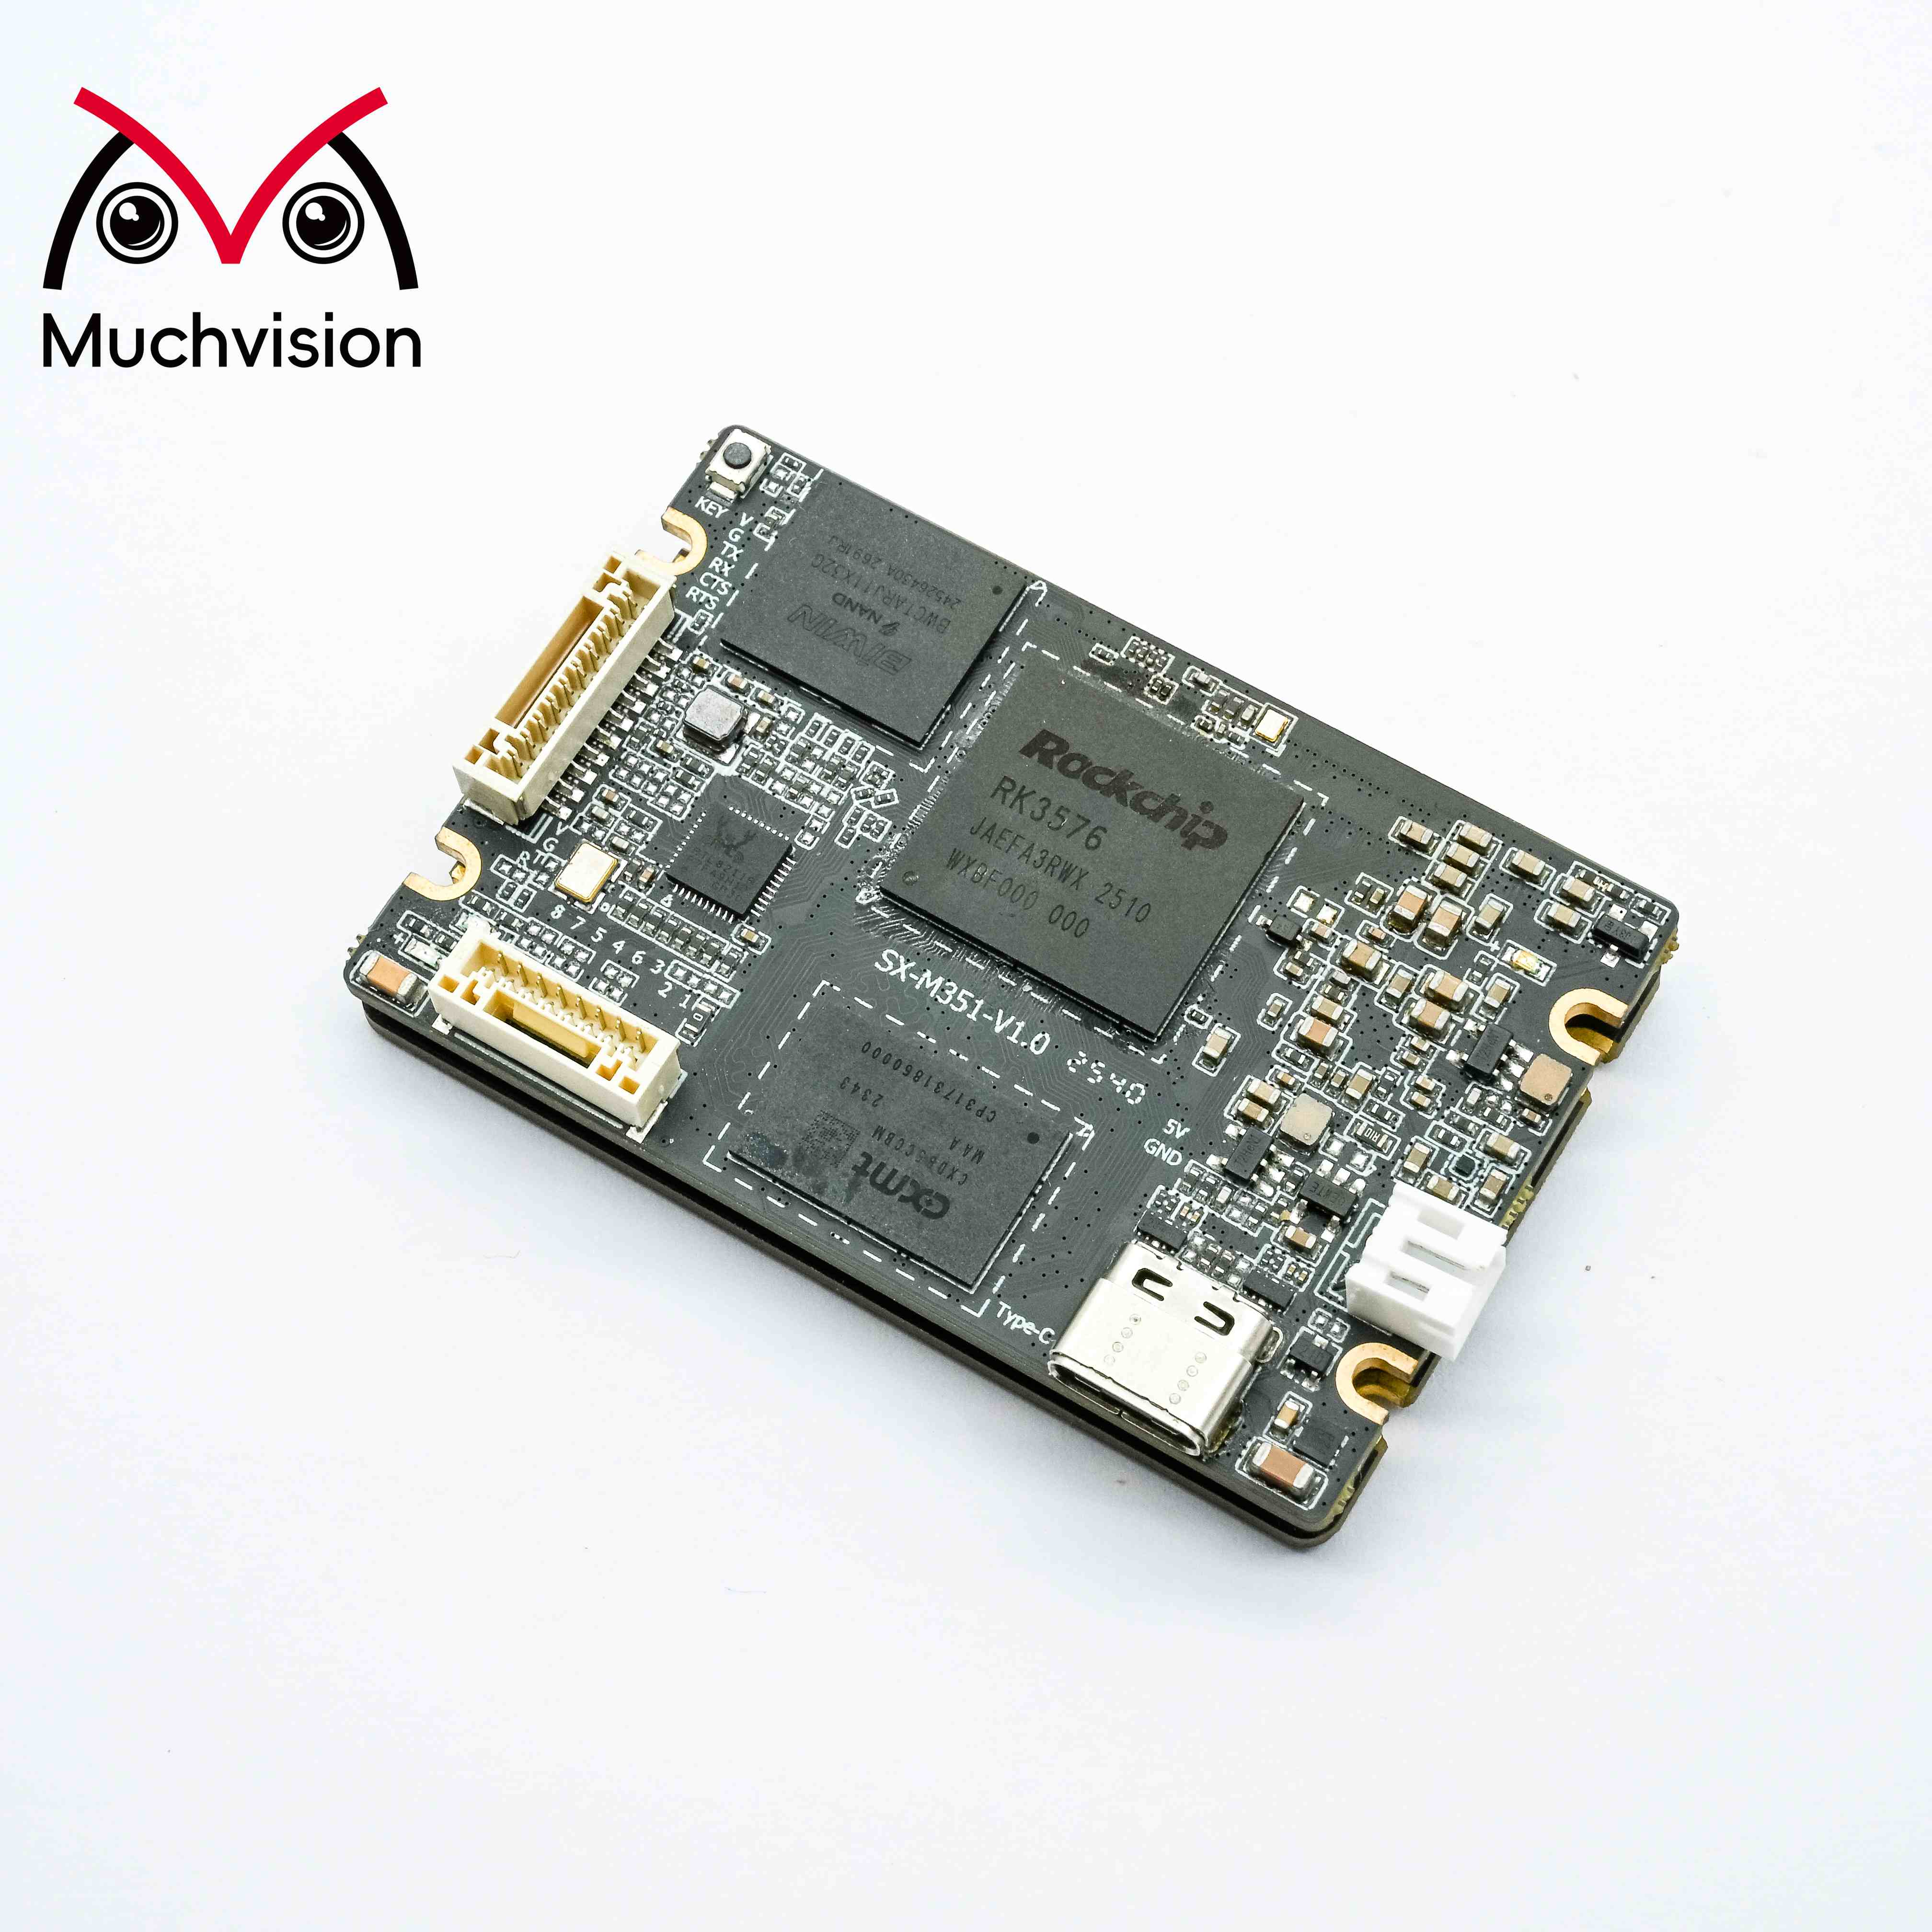
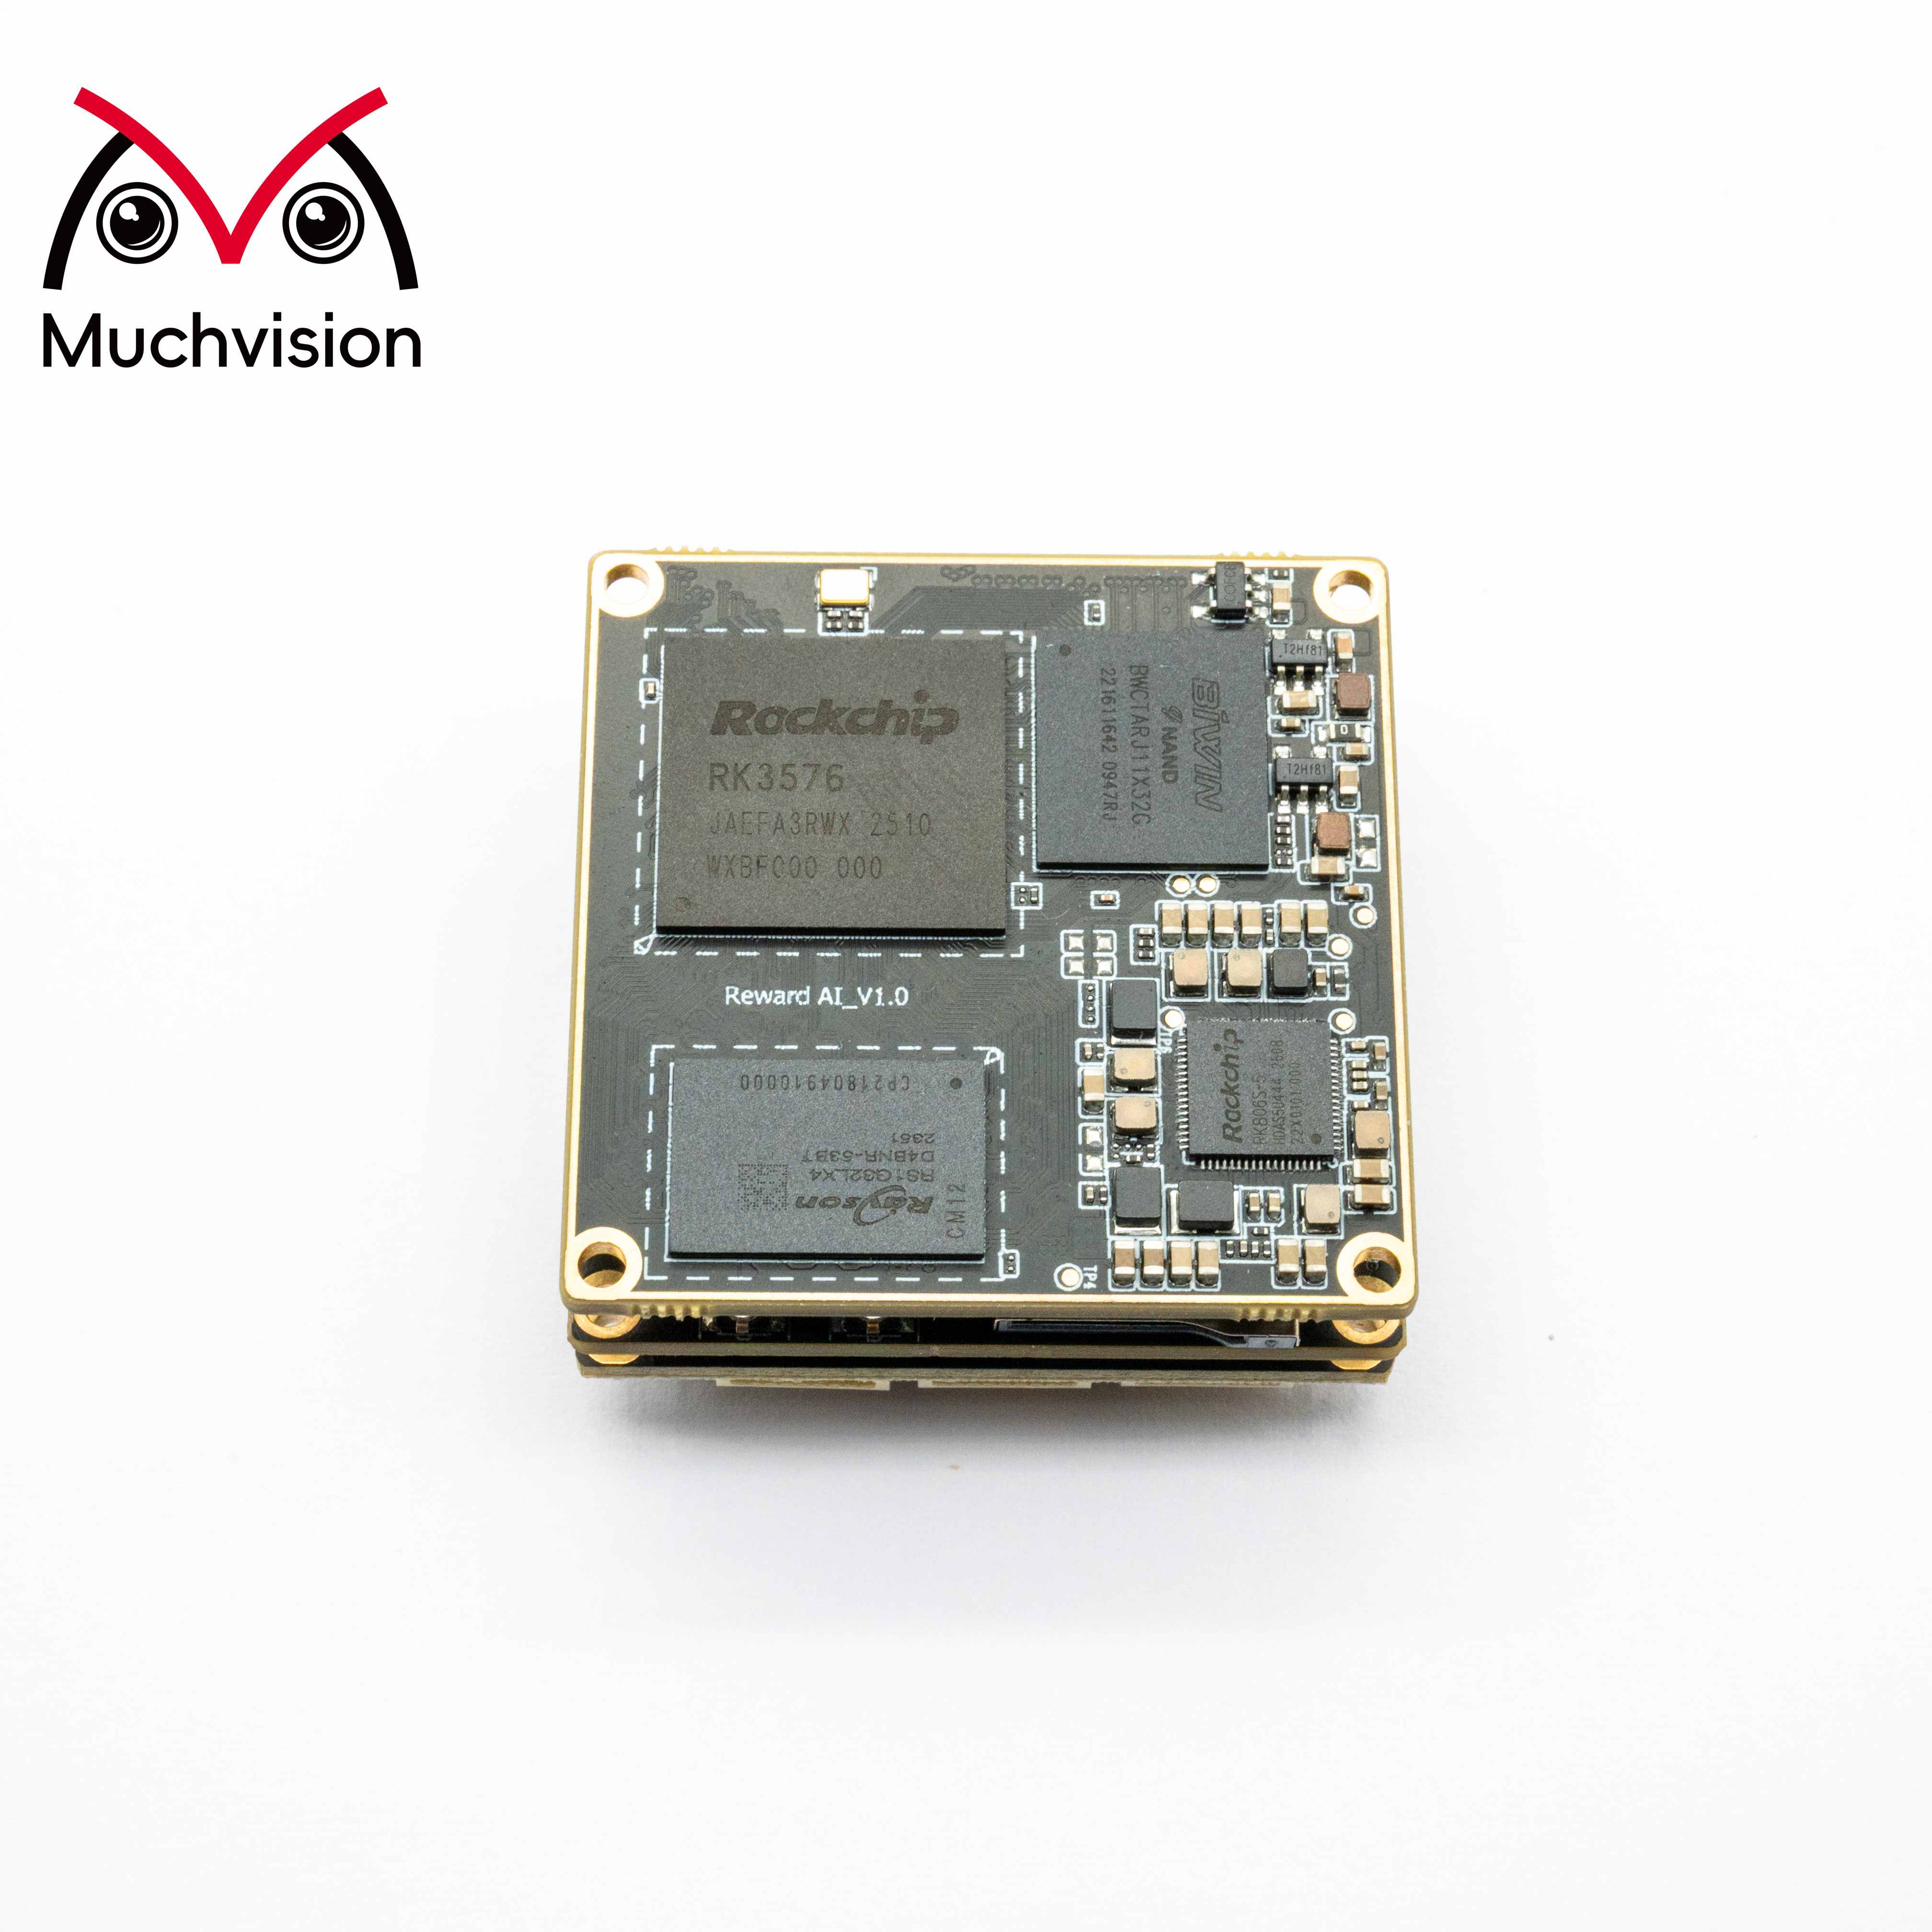
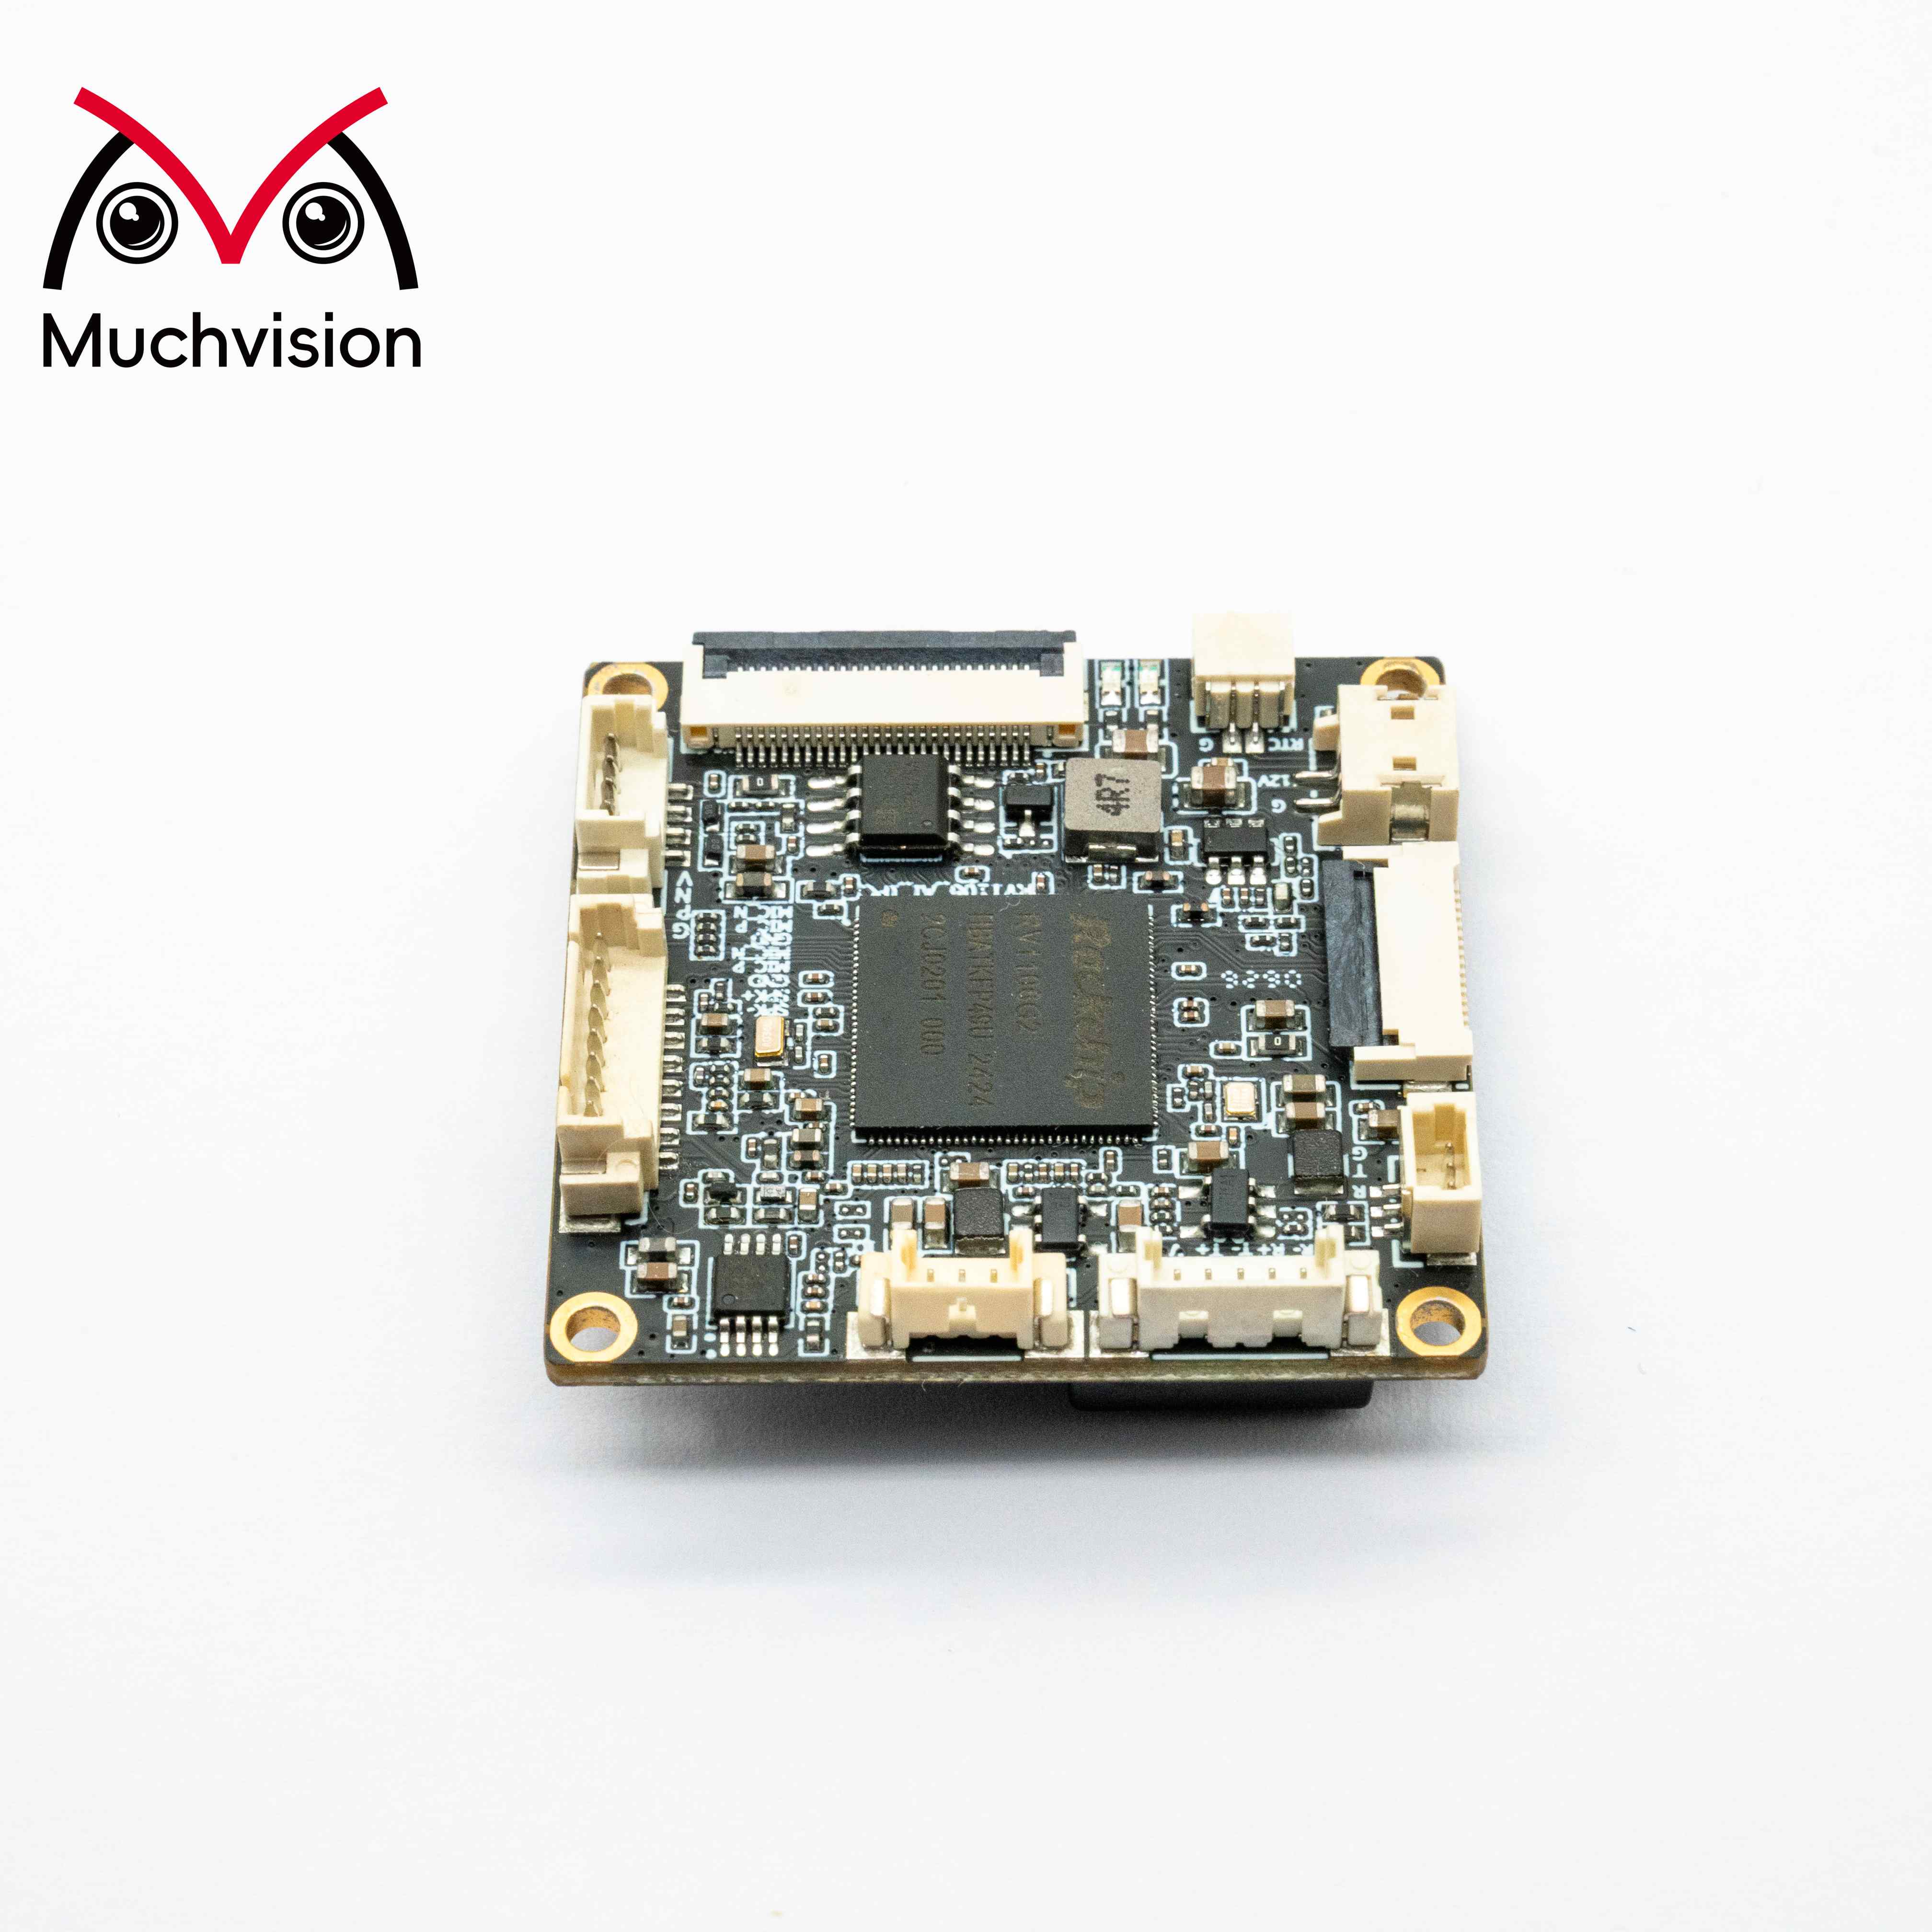
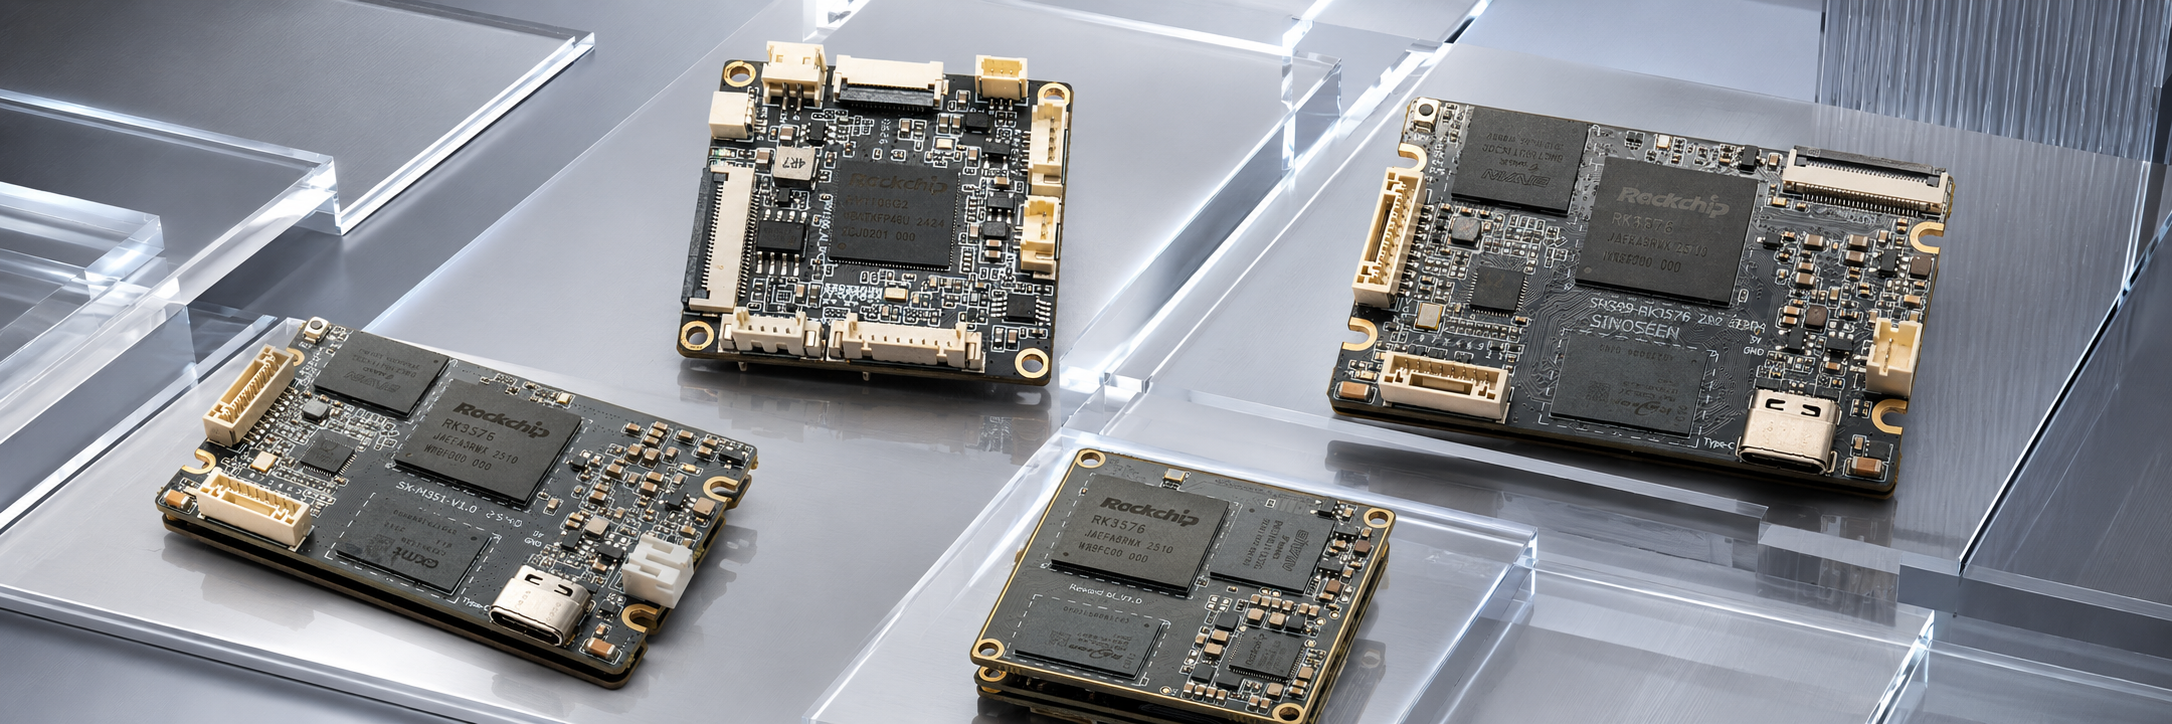
Kantdatamaskinvare spenner fra robuste IoT-gatewayer som forbruker watt til viftefrie industrielle PC-er som kjører fullstendige Kubernetes-klynger. For distribuerte nettsteder med moderate arbeidsbelastninger gir kantdatamaskinløsninger basert på ARM-prosessorer eller kompakte x86-plater energieffektivitet og termisk enkelhet, noe som er avgjørende i krevende miljøer. For tunge beregningsoppgaver eller AI-inferensoppgaver gir robuste kantdatamaskinservere med dedikerte GPU-er eller nevrale akseleratorer den nødvendige ytelsen. Beholderisering ved hjelp av Docker og Kubernetes muliggjør konsekvent programvaredistribusjon over heterogene kantdatamaskininfrastrukturer på ulike nettsteder, noe som forenkler oppdateringer og versjonskontroll.
Valg av programvare for kantdataprogrammering må balansere funksjonsrikdom mot begrensninger i ressurser. Lettvekte Linux-distribusjoner og minimale containerkjørere bevarer prosessorkapasitet for applikasjoner. Søk etter kantdataplattformer som støtter både skybaserte verktøy og tradisjonelle industrielle protokoller for å koble eldre IoT-implementasjoner med moderne arbeidsbelastninger. Din kantdatastrategi for 2026 bør kunne tilpasse seg nye AI-rammeverk, sanntidsdatabaser og sikkerhetsstandarder uten behov for arkitektonisk omforming.
Distribuerte kantdatamaskin-stasjoner øker sikkerhetsområdet ditt, noe som krever robust autentisering, kryptering og avviksgjenkjenning på hver node. Bruk sertifikatbasert autentisering for kantdatamaskin-enheter som kommuniserer med sentrale systemer, og pålegg kryptografisk signering av programvareoppdateringer som distribueres til fjerne steder. Lagring og behandling av sensitiv data på kantdatamaskin-noder – spesielt i industrielle IoT-kontekster – krever nøye tilgangskontroller og revisjonslogging.
Operativ overvåking av edge computing-utplasseringer på mange steder krever automatisering og intelligens. Sentraliserte kontrollpaneler som viser helsestatus, ytelsesmål og forsinkelse fra hver distribuerte plassering muliggjør rask feildeteksjon. Vurder edge computing-plattformer som tilbyr zero-touch-provisjonering, automatisk enhetsoppdagelse og programvareoppdateringer via push for å minimere IT-arbeid på stedet. I 2026 vil edge computing-styringsverktøy integrere AI-drevet avviksdeteksjon og selvreparerende funksjonalitet, noe som gjør distribuerte utplasseringer i stor skala mer bærekraftige.
Kantdataprogrammering oppnår vanligvis svarstider på 1–50 millisekunder for lokal behandling, sammenlignet med 50–500+ millisekunder for skybaserte runder. Den faktiske svarstiden avhenger av avstanden mellom IoT-sensoren og kanten, behandlingskompleksiteten og nettverkskvaliteten. Velutformede kantdataprogrammeringsarkitekturer for distribuerte nettsteder minimerer variasjon og garanterer deterministiske svartider for kritiske arbeidsbelastninger, noe som gjør svarstiden forutsigbar i stedet for bare lav.
Antallet noder avhenger av geografisk utbredelse, IoT-tetthet, redundanskrav og ønsket svarstid. En praktisk regel: plasser kantdataprogrammeringsnoder nær IoT-datakildene for å minimere antallet hopp fra sensor til kant, og grupper deretter kantdataprogrammeringsnodene regionalt der tilkoblingsmuligheter og administrativ effektivitet tillater det. Start med én kantdataprogrammeringsnode per større sted eller per 50–100 IoT-enheter, og utvid deretter basert på målte ytelses- og tilgjengelighetsmål.
Standarder for edge computing, AI-akselerasjon og sikkerhetspraksis utvikler seg raskt. Bygg inn fleksibilitet i din distribuerte nettstedsarkitektur ved å bruke containerebaserte arbeidsbelastninger, modulær maskinvare og API-første administrasjonslag. Innem 2026 vil mange organisasjoner integrere store språkmodeller og sanntids-AI-resonnering i edge computing-noder, så sørg for at din arkitektur støtter programvareoppdateringer og GPU-akselerasjon uten fysisk ombygging.
 Siste nytt
2026-11-06
2026-10-29
2026-10-24
2026-10-23
2026-10-20
2026-10-19

 EN