Valg af den rigtige edge Computing en arkitektur til distribuerede steder kræver omhyggelig afstemning af tekniske muligheder, forretningsmæssige mål og infrastrukturgrænser. Når organisationer udvider deres drift på tværs af flere lokationer, er behovet for realtidsbehandling, reduceret forsinkelse og lokal intelligens større end nogensinde før. Dit valg af arkitektur vil direkte påvirke den operative effektivitet, datasikkerheden og evnen til at reagere på IoT-hændelser med minimal forsinkelse.
Den grundlæggende beslutning ved implementering af edge-computing-løsninger afhænger af forståelsen af, hvor behandlingen skal finde sted – på fjerne lokaliteter, i regionale hubbe eller via en hybride model. Denne vejledning fører dig gennem de kritiske udvælgelsesfaktorer, fra latenstærskler og IoT-sensorernes tæthed til netværkets pålidelighed og den beregningskraft, der kræves på hver enkelt distribueret lokalitet. Indtil 2026 vil edge-computing-implementeringsmønstre sandsynligvis skifte mod mere sofistikerede, AI-drevne arkitekturer, hvilket gør det afgørende at opbygge rammer, der er fleksible nok til at udvikle sig.
Latenstid er den primære drivkraft bag beslutninger om edge-computing til distribuerede steder. Når IoT-følere genererer tidskritiske data – såsom overvågning af maskinernes tilstand, videoanalyse eller signaler til autonom kontrol – kan selv millisekunder med forsinkelse kompromittere sikkerhed, kvalitet eller brugeroplevelsen. Vurder latenstolerancen for hver enkelt applikationsarbejdsbyrde: missionskritiske processer kræver muligvis svarhastigheder under 100 millisekunder, mens analyse og rapportering kan tolerere forsinkelser på flere sekunder.
Din edge-computing-arkitektur skal behandle data, hvor de opstår, i stedet for at sende rådatastrømme til et centralt cloud-anlæg. Dette reducerer backhaul-båndbredde, forhindrer netværksforstoppelse og sikrer konsekvent ydelse, selv når internetforbindelsen bliver upålidelig. Dokumentér den maksimale acceptabel ventetid for hvert distribuerede steds primære brugsscenarier, og udform derefter placeringen af beregningsressourcer og dataflowet i overensstemmelse hermed. Applikationer, der involverer realtids-IoT-automatisering, prædiktiv vedligeholdelse eller sikkerhedskritiske beslutninger, drager typisk størst fordel af lokal edge-beregning.
Størrelsen og typen af IoT-enheder på hver decentraliseret lokalitet bestemmer den beregnings- og lagerkapacitet, som din edge-computing-løsning skal levere. IoT-miljøer med høj tæthed – f.eks. produktionsgulve med hundredvis af sensorer, intelligente bygningsystemer eller fjernovervågningsnetværk – genererer vedvarende datastrømme, der overvælder centraliseret cloud-beregning og forbruger uforholdsmæssig meget båndbredde. Foretag en optælling af antallet af IoT-sensorer, datafrekvensen og størrelsen af datalasten pr. lokalitet for at fastslå den grundlæggende behandlingskrav.
Overvej ikke kun den nuværende sensorbelastning, men også den forventede vækst indtil 2026. Organisationer, der tilføjer IoT-funktioner eller udvider automatiseringen på tværs af faciliteter, har brug for arkitekturer, der kan skaleres smidigt. At foruddefinere edge-computing-kapacitet til fremtidig IoT-vækst reducerer dyre ombygninger og forstyrrelser under migration. Arkitekturer til decentraliserede lokaliteter bør modularisere beregningsressourcer, så yderligere behandlingsenheder kan integreres problemfrit, når IoT-tætheden stiger.
Tre primære edge-computing-arkitekturmønstre tjener distribuerede steder, hver med tydelige kompromiser. En centraliseret edge-model koncentrerer beregningskraften på et lille antal regionale hubbe, hvilket reducerer den operative kompleksitet og investeringen i hardware, men introducerer backhaul-latenstid og potentielle enkeltfejl. Denne tilgang er velegnet for organisationer med forudsigelige trafikmønstre og løst tidsfølsomme arbejdsbelastninger. Omvendt placerer fuldstændig distribueret edge-computing beregningsressourcer på hvert fjernt sted, hvilket garanterer minimal latens og maksimal robusthed, men samtidig øger administrations-, vedligeholdelses- og licenskompleksiteten på tværs af dusinvis eller hundredvis af lokationer.
De mest modne implementeringer anvender en hybrid edge-computing-model, der stratificerer behandlingen: tidskritiske opgaver udføres lokalt ved hjælp af letvægtsberegning, mens ressourcekrævende analyser og langtidsopbevaring udnytter regionale eller skybaserede faciliteter. Denne afbalancerede tilgang udnytter fordelene ved edge computing dér, hvor latenstiden er afgørende, samtidig med at den begrænser driftsomkostningerne. Hybride design passer godt til IoT-arbejdsbelastninger, der kombinerer realtidsfusionsanalyse af sensorer med batch-analyser. Vurder din arbejdsbelastningsblanding, dine IT-personalebegrænsninger og din budgetramme for at fastslå den rigtige placering for dine distribuerede steder.
Netværkstopologi påvirker ydeevnen og robustheden af edge-computing i distribuerede miljøer. Hvis alle edge-computing-noder på fjerne steder skal kommunikere via én enkelt opstigningsforbindelse til en central administrationshub, risikerer man flaskehalse og kaskadeafbrud. Implementér lokalnetværksclustering, hvor edge-computing-noder kan samarbejde med nabonoder, inden de sender aggregerede indsigt videre opad i netværket. Denne arkitektur reducerer båndbreddebelastningen på backbone-netværket, forbedrer fejlisolering og øger robustheden, når forbindelsen brydes.
Inden 2026 vil edge-computing-arkitekturer i stigende grad integrere mesh-netværk, hvor distribuerede lokationer opretholder direkte peer-to-peer-forbindelser samt forbindelser til skyen. Mesh-topologier fordeler behandlingsintelligens på tværs af netværket og gør det muligt for lokationer at opretholde delvis autonomi under udvalgte netværksudfald. Vurder den geografiske spredning af dine distribuerede lokationer, forbindelsens pålidelighed samt kravene til samarbejde mellem lokationer, når du vælger en topologi. Mission-kritiske eller fjerne lokationer drager særligt fordel af edge-computing-løsninger med mesh-funktioner.
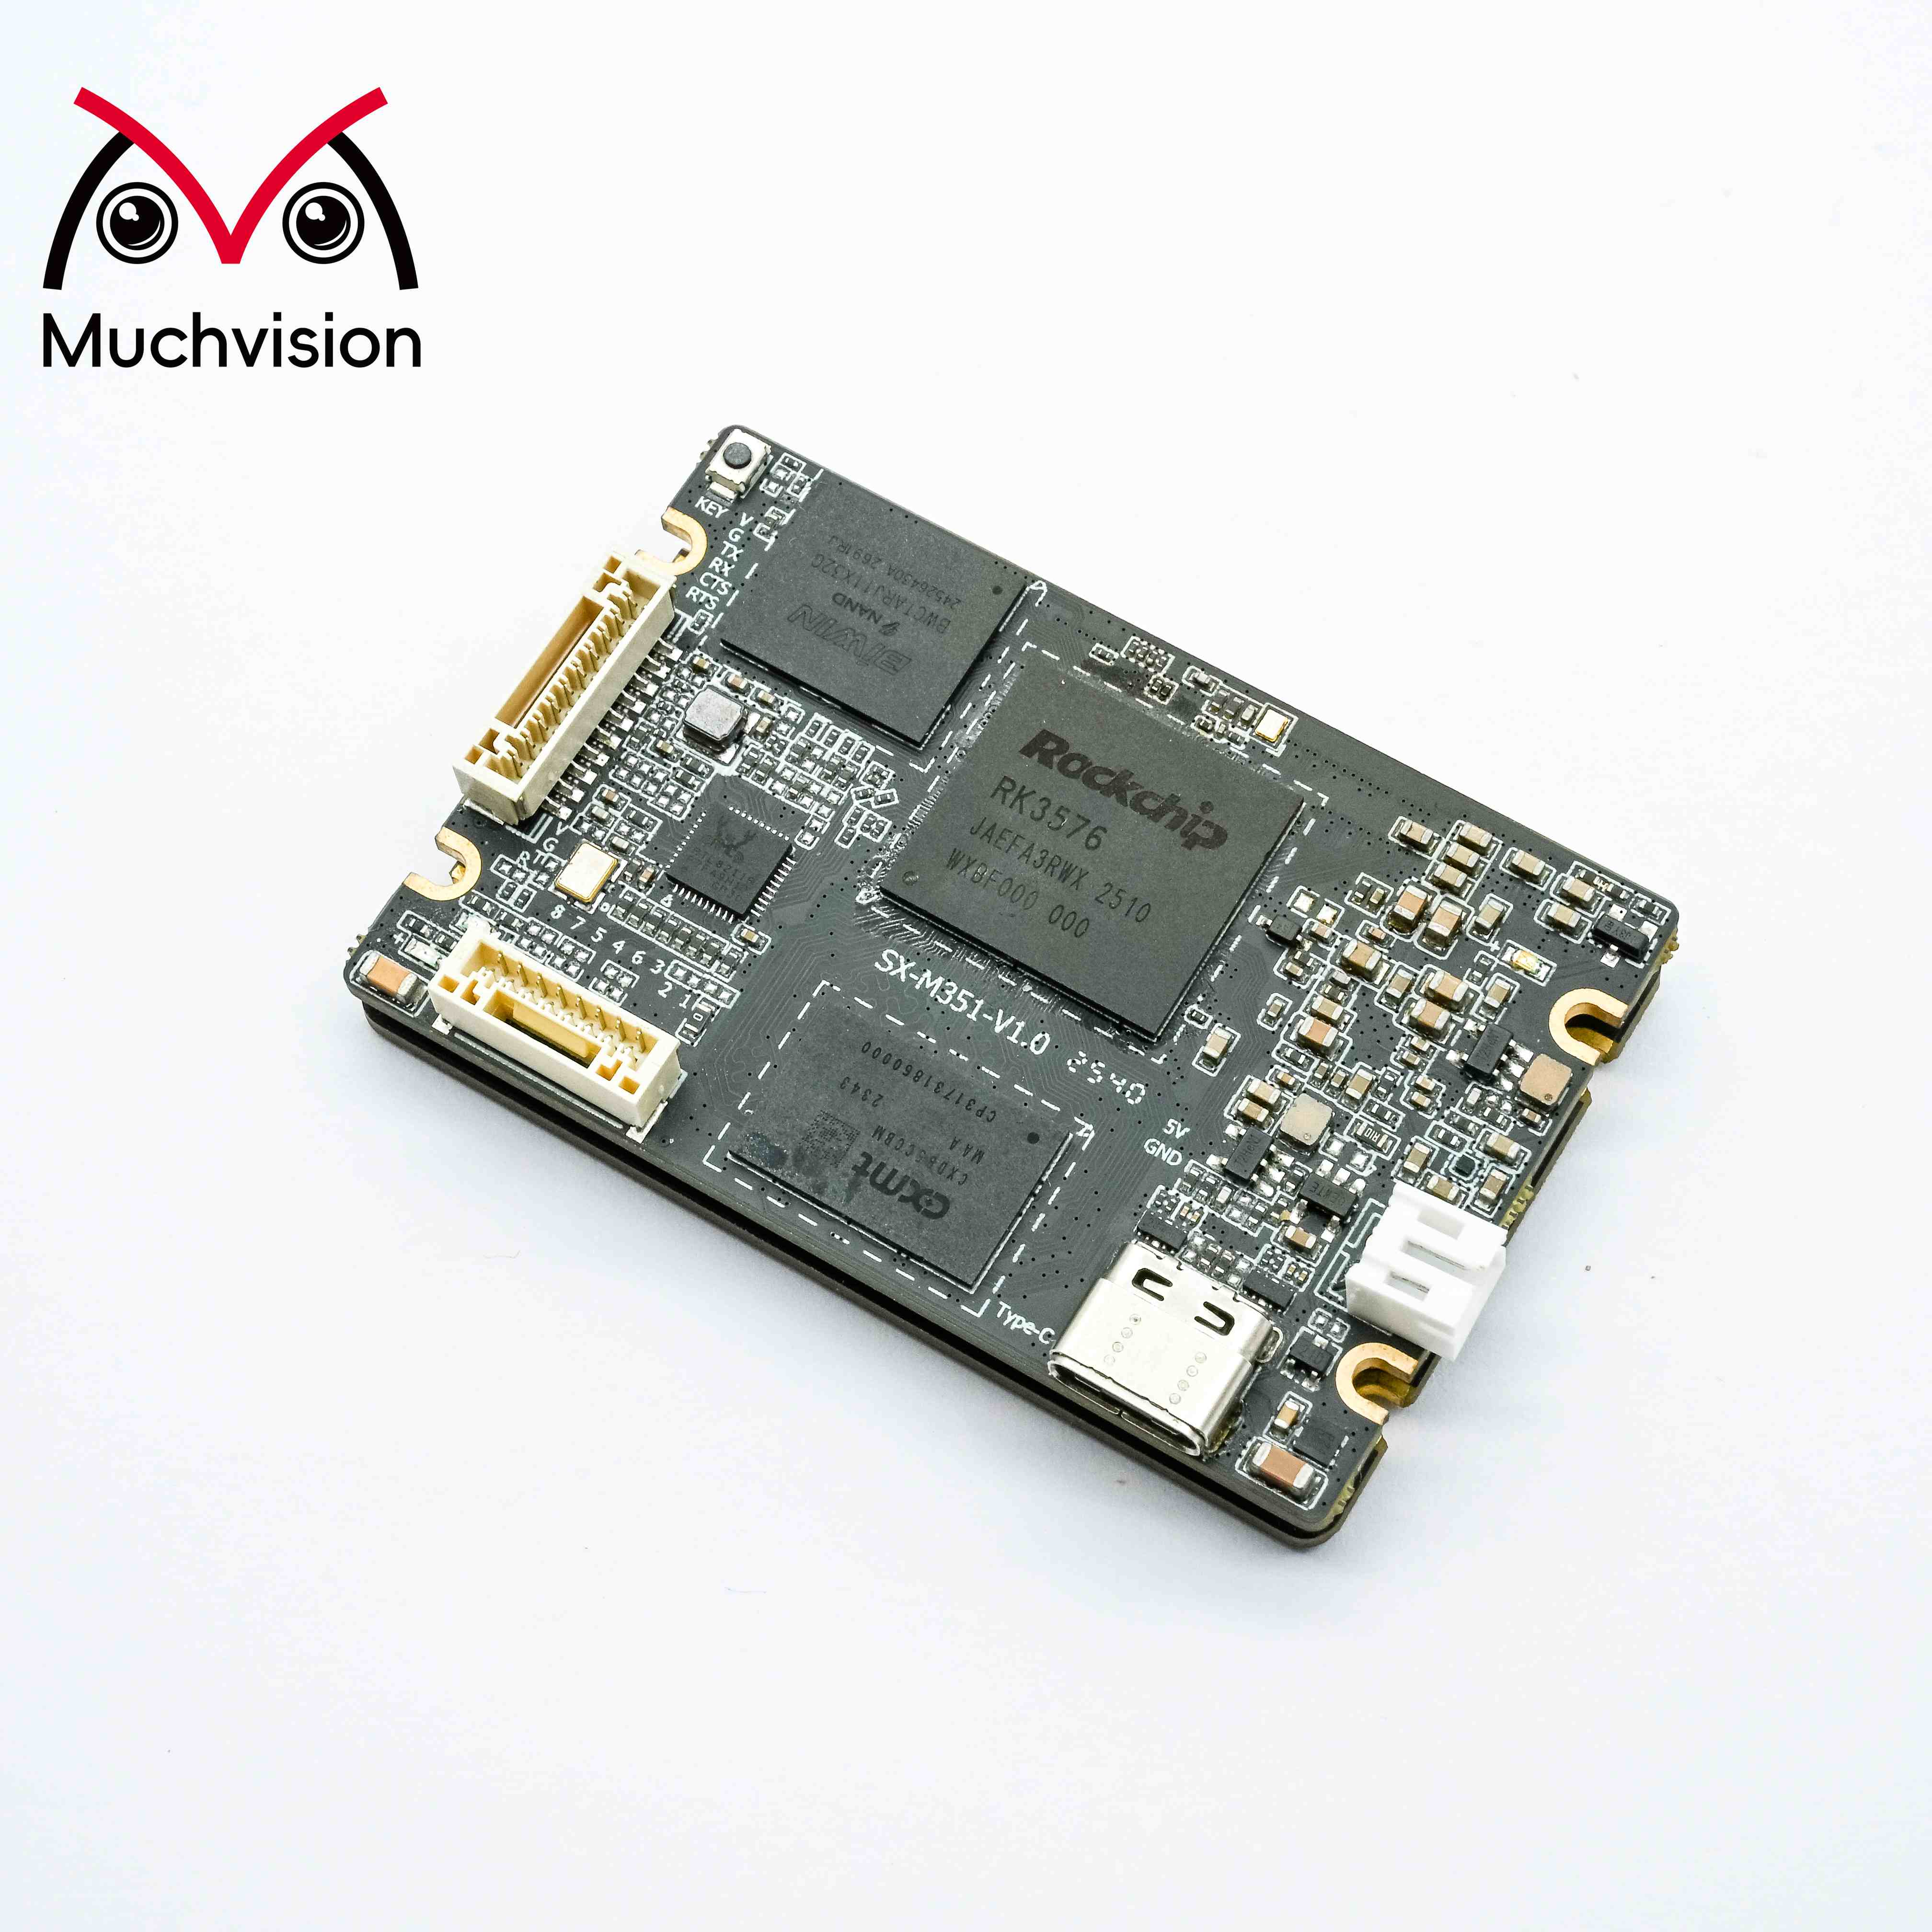
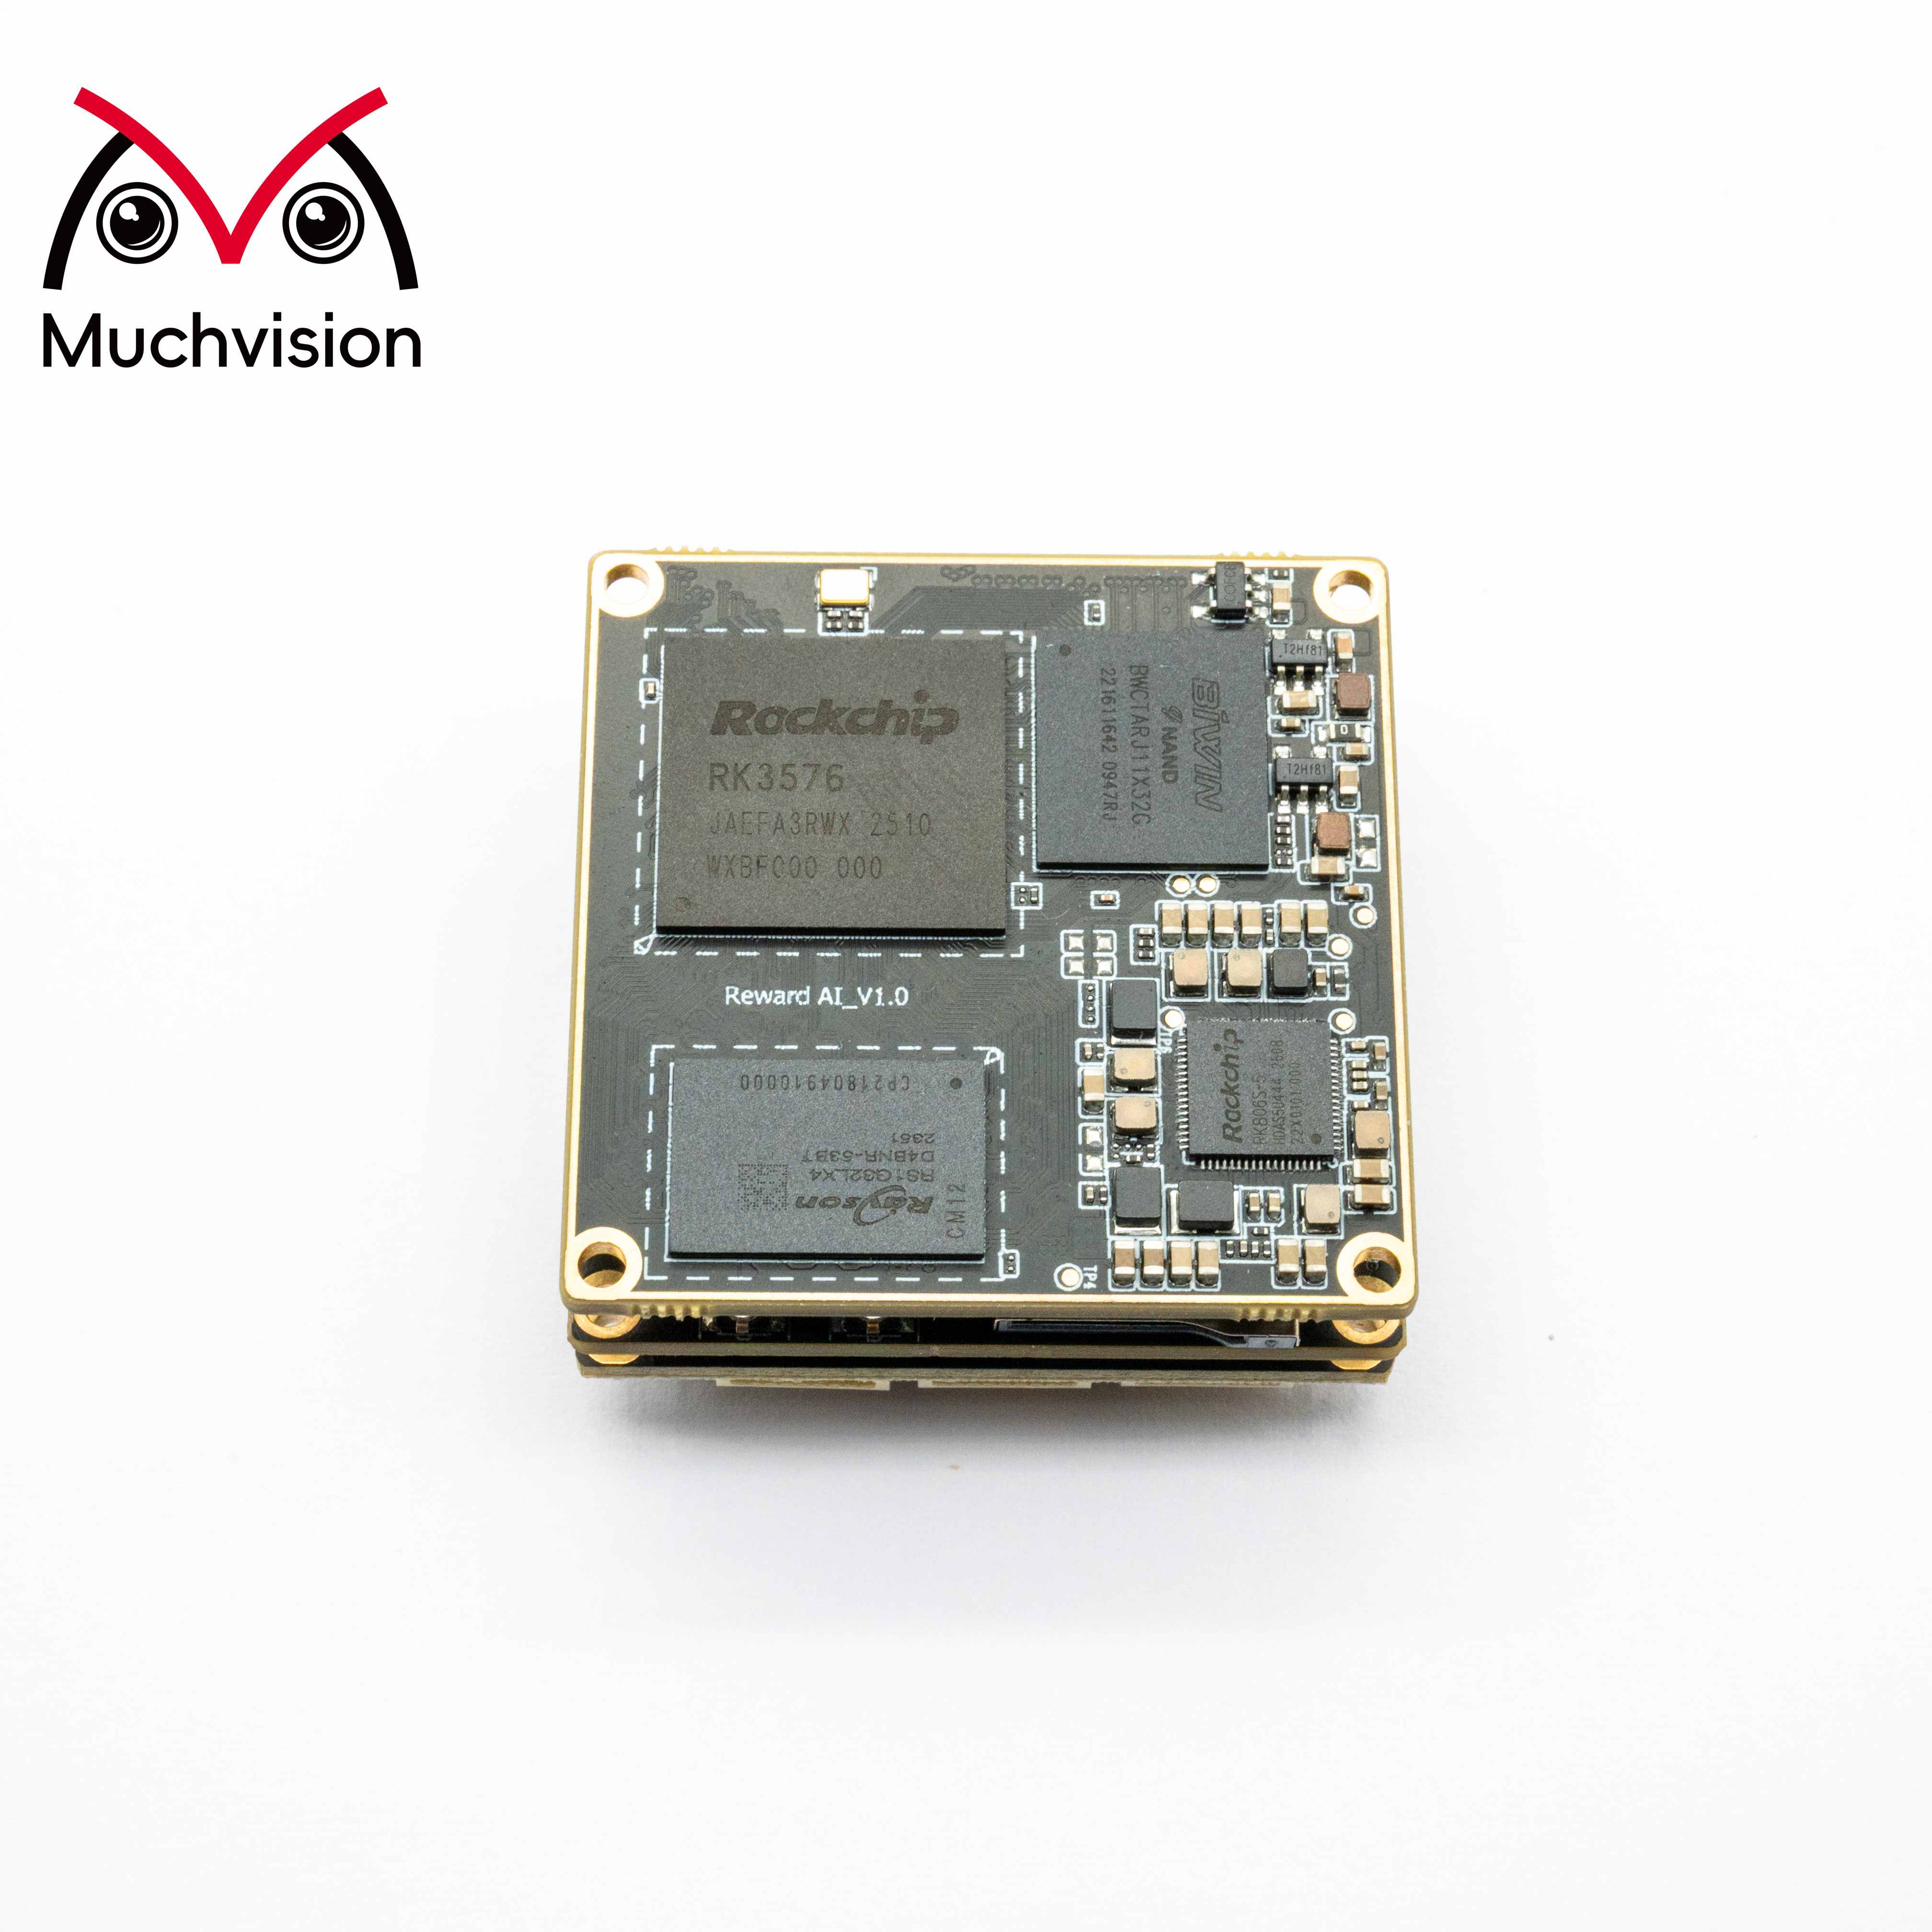
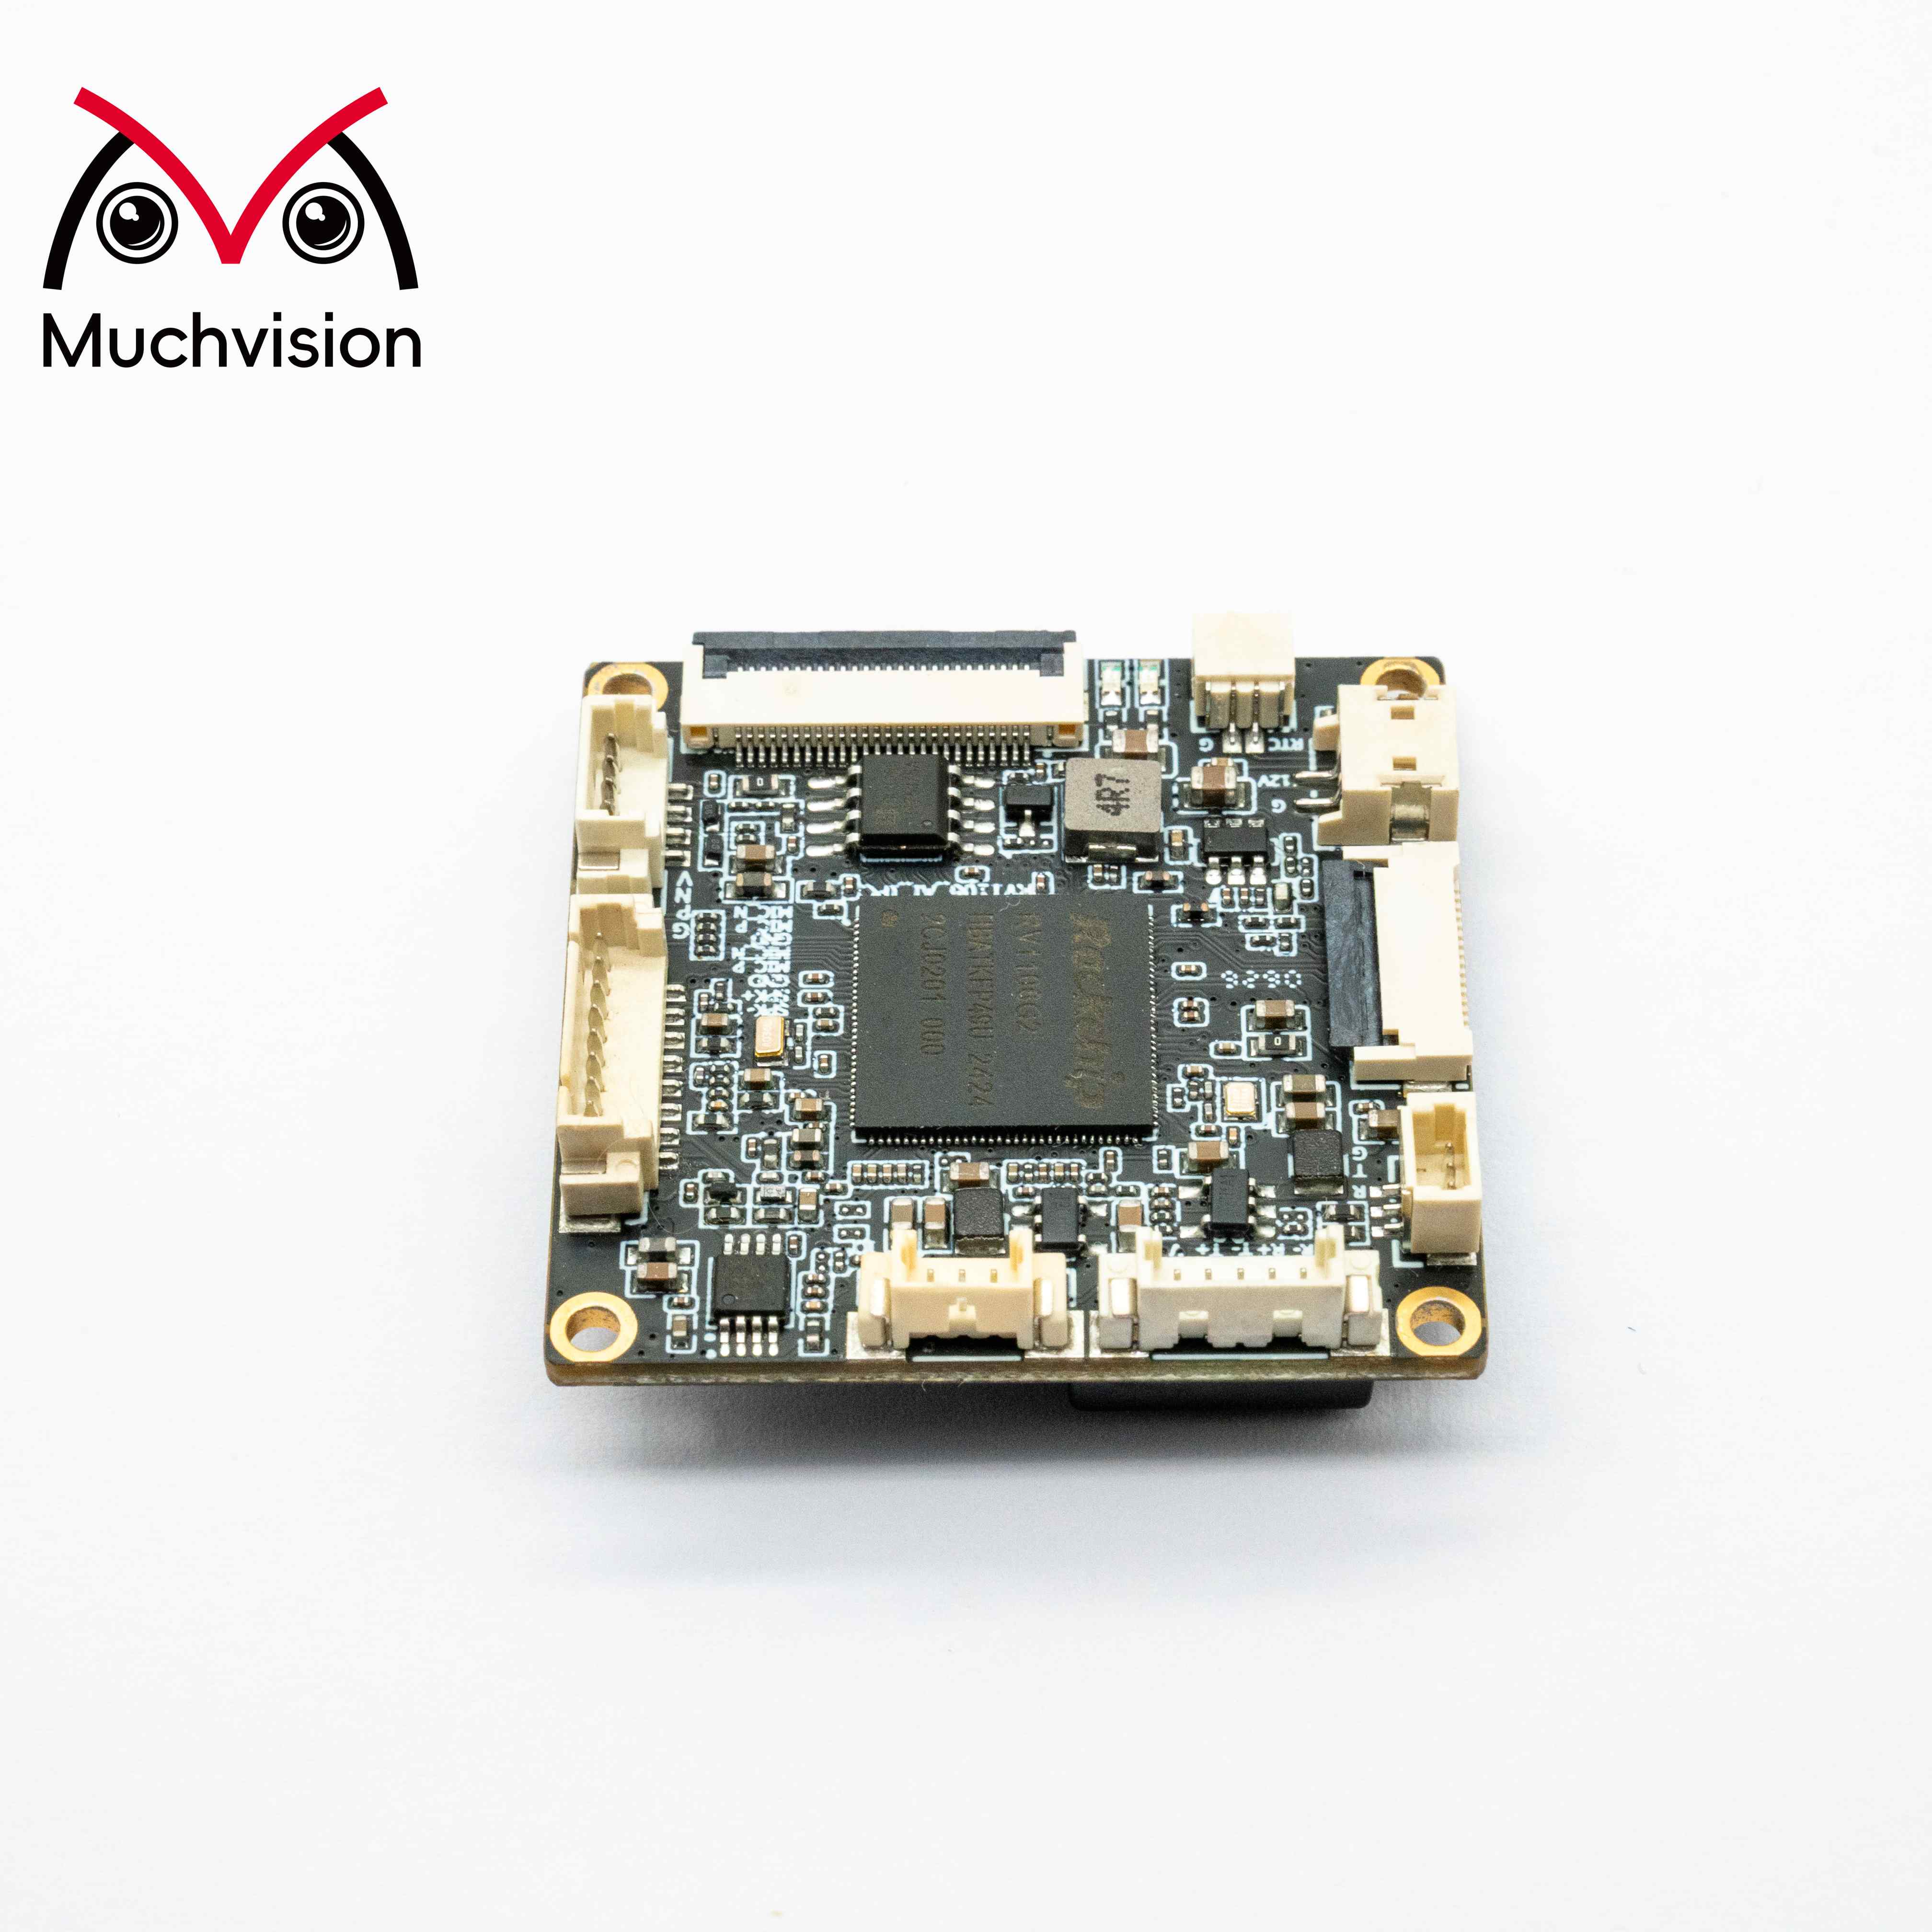
Edge-computing-hardware spænder fra robuste IoT-gateways, der forbruger watt, til ventilationsløse industrielle PC’er, der kører fuldstændige Kubernetes-klynger. For distribuerede lokationer med moderate arbejdsbyrder tilbyder edge-computing-løsninger baseret på ARM-processorer eller kompakte x86-plader energieffektivitet og termisk enkelhed, hvilket er afgørende i udfordrende miljøer. For tunge beregningsopgaver eller AI-inferens-opgaver leverer robuste edge-computing-servere med dedikerede GPU’er eller neurale accelerators den nødvendige ydeevne. Containerisering ved hjælp af Docker og Kubernetes muliggør konsekvent softwareinstallation på heterogene edge-computing-infrastrukturer på forskellige lokationer, hvilket forenkler opdateringer og versionsstyring.
Softwarevalg til edge computing skal afbalancere funktionsrigdom mod ressourcebegrænsninger. Letvægts-Linux-distributioner og minimale containerkørselsmiljøer bevarer behandlingskapacitet til applikationer. Søg efter edge computing-platforme, der understøtter både sky-native værktøjer og traditionelle industrielle protokoller, for at skabe bro mellem eksisterende IoT-installationer og moderne arbejdsbelastninger. Din edge computing-strategi for 2026 skal kunne rumme fremadrettet AI-rammeværker, realtidsdatabaser og sikkerhedsstandarder uden behov for arkitektonisk ombygning.
Distribuerede edge-computing-steder forøger din sikkerhedsområde, hvilket kræver robust godkendelse, kryptering og anomaliodsætning på hvert node. Implementer certifikatbaseret godkendelse for edge-computing-enheder, der kommunikerer med centrale systemer, og gennemfør kryptografisk signering af softwareopdateringer, der distribueres til fjerne lokationer. Lagring og behandling af følsomme data på edge-computing-noder – især i industrielle IoT-kontekster – kræver omhyggelige adgangskontroller og revisionslogning.
Driftsmonitorering af edge computing-installationer på mange steder kræver automatisering og intelligens. Centraliserede kontrolelementer, der viser status, ydelsesmålinger og ventetid fra hver distribueret lokalitet, gør det muligt at opdage problemer hurtigt. Overvej edge computing-platforme, der tilbyder zero-touch-provisioning, automatisk enhedsopdagelse og softwareopdateringer via push for at minimere den lokale IT-indsats. I 2026 kan man forvente, at edge computing-styringsværktøjer integrerer AI-drevet anomaliodkrydelse og selvreparerende funktioner, hvilket gør store, distribuerede installationer mere bæredygtige.
Edge-computing opnår typisk ventetider på 1–50 millisekunder for lokal behandling, i modsætning til 50–500+ millisekunder for cloud-rundture. Den faktiske ventetid afhænger af afstanden mellem din IoT-sensor og edge-enheden, behandlingskompleksiteten og netværkskvaliteten. Veludformede edge-computing-arkitekturer til distribuerede steder minimerer variabiliteten og garanterer deterministiske svartider for kritiske arbejdsbelastninger, hvilket gør ventetiden forudsigelig i stedet for blot lav.
Antallet af noder afhænger af det geografiske område, IoT-tætheden, redundanskravene og den ønskede ventetid. En praktisk regel er at placere edge-computing tæt på IoT-datakilderne for at minimere antallet af hop fra sensor til edge, og derefter gruppere edge-computing-noder regionalt, hvor forbindelseskvaliteten og administrativ effektivitet tillader det. Start med én edge-computing-node pr. større lokalitet eller pr. 50–100 IoT-enheder, og udvid derefter baseret på målte ydeevne- og tilgængelighedsmål.
Edge-computing-standarder, AI-acceleration og sikkerhedspraksis udvikler sig hurtigt. Indbyg fleksibilitet i din distribuerede site-arkitektur ved at anvende containeriserede arbejdsbelastninger, modulære hardwarekomponenter og API-første administrationslag. Inden 2026 vil mange organisationer integrere store sprogmodeller (LLM) og realtidsbaseret AI-ræsonnement i deres edge-computing-noder, så sikr, at din arkitektur understøtter softwareopdateringer og GPU-acceleration uden fysisk ombygning.
 Seneste nyheder
2026-11-06
2026-10-29
2026-10-24
2026-10-23
2026-10-20
2026-10-19

 EN