 ×
Wybór właściwego obliczenia na Krawędzi architektura dla rozproszonych lokalizacji wymaga starannego wyrównania możliwości technicznych, celów biznesowych i ograniczeń infrastrukturalnych. Wraz z rozszerzaniem działalności organizacji na wiele lokalizacji popyt na przetwarzanie w czasie rzeczywistym, niskie opóźnienie i lokalną inteligencję nigdy nie był większy. Wybór Państwa architektury bezpośrednio wpłynie na efektywność operacyjną, bezpieczeństwo danych oraz możliwość reagowania na zdarzenia IoT z minimalnym opóźnieniem.
Podstawową decyzją przy wdrażaniu rozwiązań obliczeń brzegowych jest zrozumienie, gdzie powinna odbywać się przetwarzanie danych — na oddalonych lokalizacjach, w centrach regionalnych czy też w oparciu o model hybrydowy. Ten przewodnik przedstawia kluczowe czynniki wpływające na wybór rozwiązania, od wymagań dotyczących opóźnień i gęstości czujników IoT po niezawodność sieci oraz moc obliczeniową niezbędną na każdej z rozproszonych lokalizacji. Do 2026 roku wzorce wdrażania obliczeń brzegowych prawdopodobnie przesuną się ku bardziej zaawansowanym, wspieranym przez sztuczną inteligencję architekturom, co czyni niezbędne budowanie elastycznych ram pracy, zdolnych do ewolucji.
Opóźnienie jest głównym czynnikiem decydującym o zastosowaniu obliczeń brzegowych w rozproszonych lokalizacjach. Gdy czujniki IoT generują dane wymagające natychmiastowej reakcji — na przykład dane dotyczące stanu maszyn, analizę wideo lub sygnały sterujące systemami autonomicznymi — nawet milisekundy opóźnienia mogą zagrozić bezpieczeństwu, jakości lub doświadczeniu użytkownika. Dokonaj oceny tolerancji na opóźnienie dla każdego obciążenia aplikacji: procesy krytyczne dla misji mogą wymagać czasów odpowiedzi poniżej 100 milisekund, podczas gdy analizy i raportowanie mogą tolerować opóźnienia rzędu sekund.
Architektura przetwarzania brzegowego musi przetwarzać dane tam, gdzie powstają, zamiast przesyłać surowe strumienie do scentralizowanego udogodnienia chmurowego. Dzięki temu zmniejsza się zapotrzebowanie na pasmo przepustowości w kierunku szczytowym, zapobiega się przepełnieniu sieci oraz zapewnia się spójną wydajność nawet w przypadku niestabilnego połączenia z internetem. Udokumentuj maksymalnie dopuszczalne opóźnienie dla głównych przypadków użycia w każdej rozproszonej lokalizacji, a następnie zaprojektuj rozmieszczenie zasobów obliczeniowych i przepływ danych zgodnie z tymi wymaganiami. Aplikacje obejmujące automatyzację IoT w czasie rzeczywistym, utrzymanie predykcyjne lub decyzje krytyczne pod względem bezpieczeństwa najczęściej korzystają z przetwarzania lokalnego na brzegu sieci.
Skala i typ urządzeń IoT w poszczególnych rozproszonych lokalizacjach określają obliczeniową i pamięciową wydajność rozwiązania obliczeń brzegowych, jakie należy zapewnić. Środowiska IoT o wysokiej gęstości — takie jak hale produkcyjne wyposażone w setki czujników, inteligentne systemy budynkowe lub sieci zdalnego monitoringu — generują ciągłe strumienie danych, które przeciążają przetwarzanie w chmurze centralnej i zużywają nieproporcjonalnie dużo przepustowości. Przeprowadź inwentaryzację liczby czujników IoT, częstotliwości generowania danych oraz rozmiaru ładunku danych na każdą lokalizację, aby ustalić podstawowe wymagania przetwarzania.
Rozważ nie tylko obecne obciążenie czujnikami, ale także przewidywany wzrost do 2026 roku. Organizacje wdrażające nowe funkcje IoT lub rozszerzające automatyzację w swoich obiektach potrzebują architektur skalowalnych w sposób płynny. Wcześniejsze przygotowanie mocy obliczeniowej brzegowej na przyszły wzrost liczby urządzeń IoT pozwala uniknąć kosztownych przebudów oraz zakłóceń związanych z migracją. Architektury rozproszonych lokalizacji powinny modularnie organizować zasoby obliczeniowe, umożliwiając bezproblemową integrację dodatkowych jednostek przetwarzania w miarę wzrostu gęstości urządzeń IoT.
Istnieją trzy główne wzorce architektury obliczeń brzegowych przeznaczone dla rozproszonych lokalizacji, z których każdy wiąże się z innymi kompromisami. W scentralizowanym modelu brzegowym moc obliczeniowa jest skupiona w niewielkiej liczbie regionalnych centrów, co zmniejsza złożoność operacyjną oraz inwestycje w sprzęt, ale wprowadza opóźnienia związane z ruchem zwrotnym (backhaul) oraz ryzyko awarii w jednym punkcie. Takie podejście nadaje się do organizacji o przewidywalnych wzorcach ruchu sieciowego oraz obciążeniach niezbyt wymagających ścisłej synchronizacji czasowej. Z kolei w pełni rozproszona architektura obliczeń brzegowych umieszcza zasoby obliczeniowe w każdej oddalonej lokalizacji, zapewniając minimalne opóźnienia oraz maksymalną odporność, lecz znacznie zwiększa złożoność zarządzania, konserwacji oraz licencjonowania na dziesiątkach lub setkach miejsc.
Najbardziej dojrzałe wdrożenia wykorzystują hybrydowy model obliczeń brzegowych, który warstwuje przetwarzanie: zadania krytyczne pod względem opóźnienia są wykonywane lokalnie przy użyciu lekkich jednostek obliczeniowych, podczas gdy zasobożądne analizy i długoterminowe przechowywanie danych korzystają z obiektów regionalnych lub chmurowych. Takie zrównoważone podejście wykorzystuje zalety obliczeń brzegowych tam, gdzie opóźnienie ma największe znaczenie, jednocześnie ograniczając koszty operacyjne. Projektowanie hybrydowe dobrze sprawdza się w przypadku obciążeń IoT łączących fuzję danych czujników w czasie rzeczywistym z analizami wsadowymi. Przeanalizuj swój mix obciążeń, ograniczenia kadrowe działu IT oraz budżet, aby określić optymalne rozmieszczenie dla swoich rozproszonych lokalizacji.
Topologia sieci wpływa na wydajność i odporność obliczeń brzegowych w środowiskach rozproszonych. Jeśli wszystkie węzły obliczeń brzegowych w oddalonych lokalizacjach muszą komunikować się poprzez pojedyncze łącze w górę z centralnym centrum zarządzania, istnieje ryzyko powstania wąskich gardeł oraz awarii kaskadowych. Wdroż klastry sieci lokalnej, w których węzły obliczeń brzegowych mogą współpracować ze swoimi sąsiadami przed wysłaniem zagregowanych informacji w górę strumienia. Takie rozwiązanie zmniejsza zapotrzebowanie na przepustowość szkieletu sieci, poprawia izolację błędów oraz zwiększa odporność w przypadku utraty łączności.
Do 2026 roku architektury obliczeń brzegowych coraz częściej będą obejmować sieci typu mesh, w których rozproszone lokalizacje utrzymują bezpośrednie połączenia typu peer-to-peer równolegle z połączeniami z chmurą. Topologie typu mesh rozprowadzają inteligencję przetwarzania w całej sieci i umożliwiają lokalizacjom zachowanie częściowej autonomii podczas awarii sieci o szerokim zasięgu. Przy wyborze topologii należy ocenić geograficzny zasięg rozproszonych lokalizacji, niezawodność połączeń oraz wymagania dotyczące współpracy między lokalizacjami. Lokalizacje krytyczne z punktu widzenia realizacji misji lub oddalone korzystają szczególnie z wdrożeń obliczeń brzegowych obsługujących sieci typu mesh.
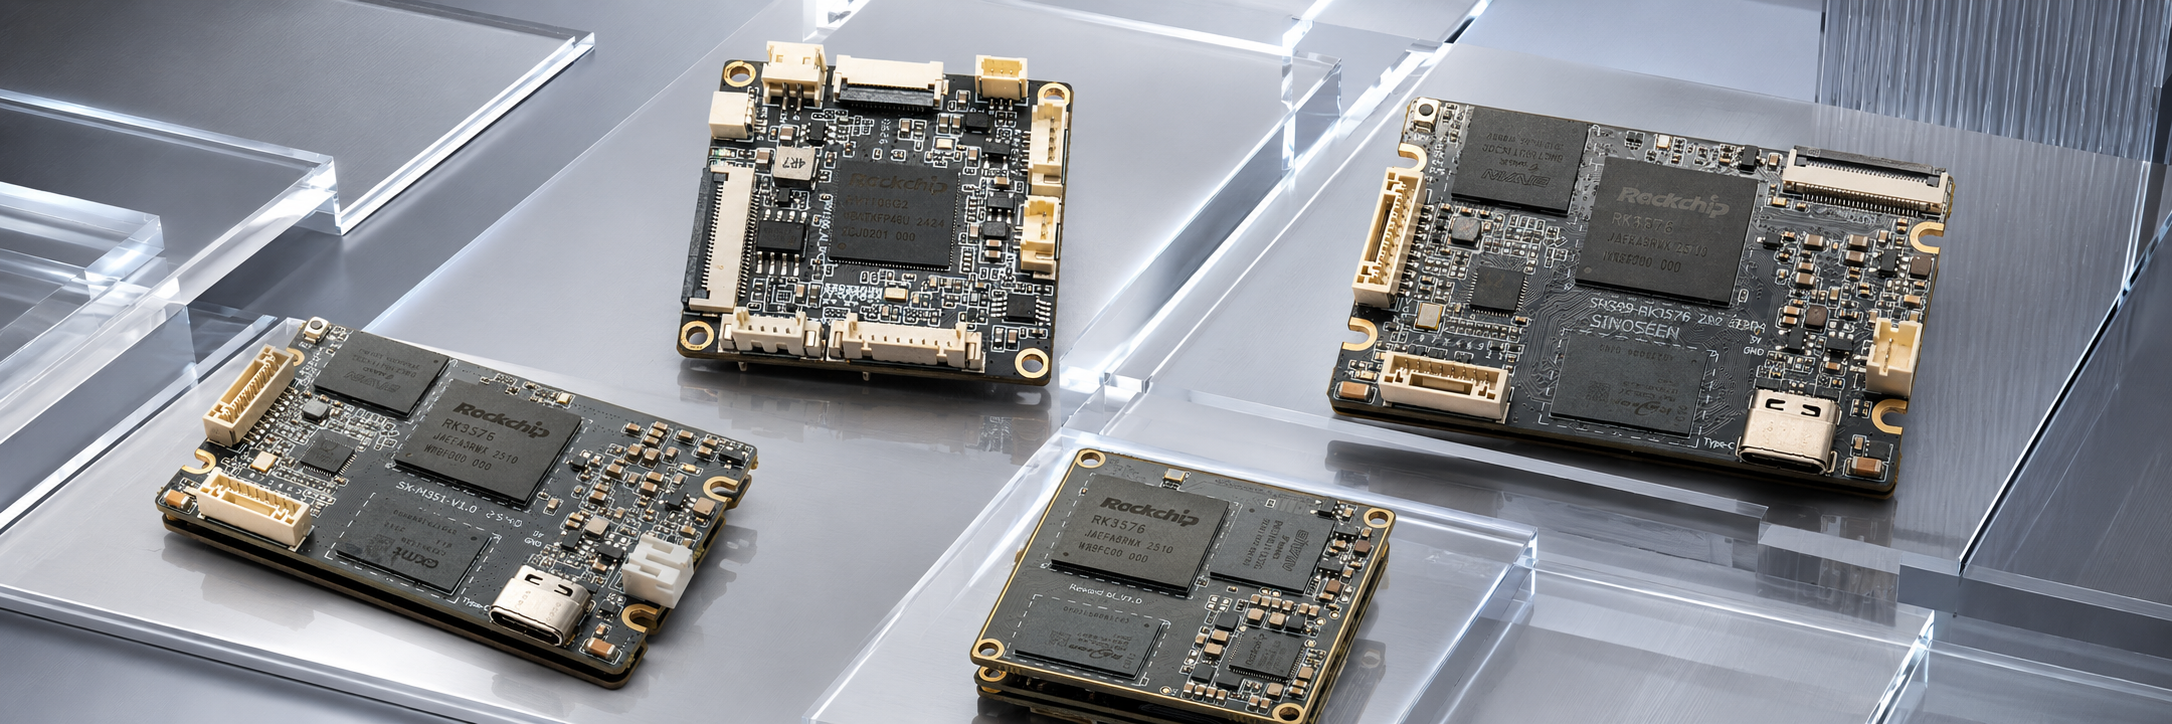
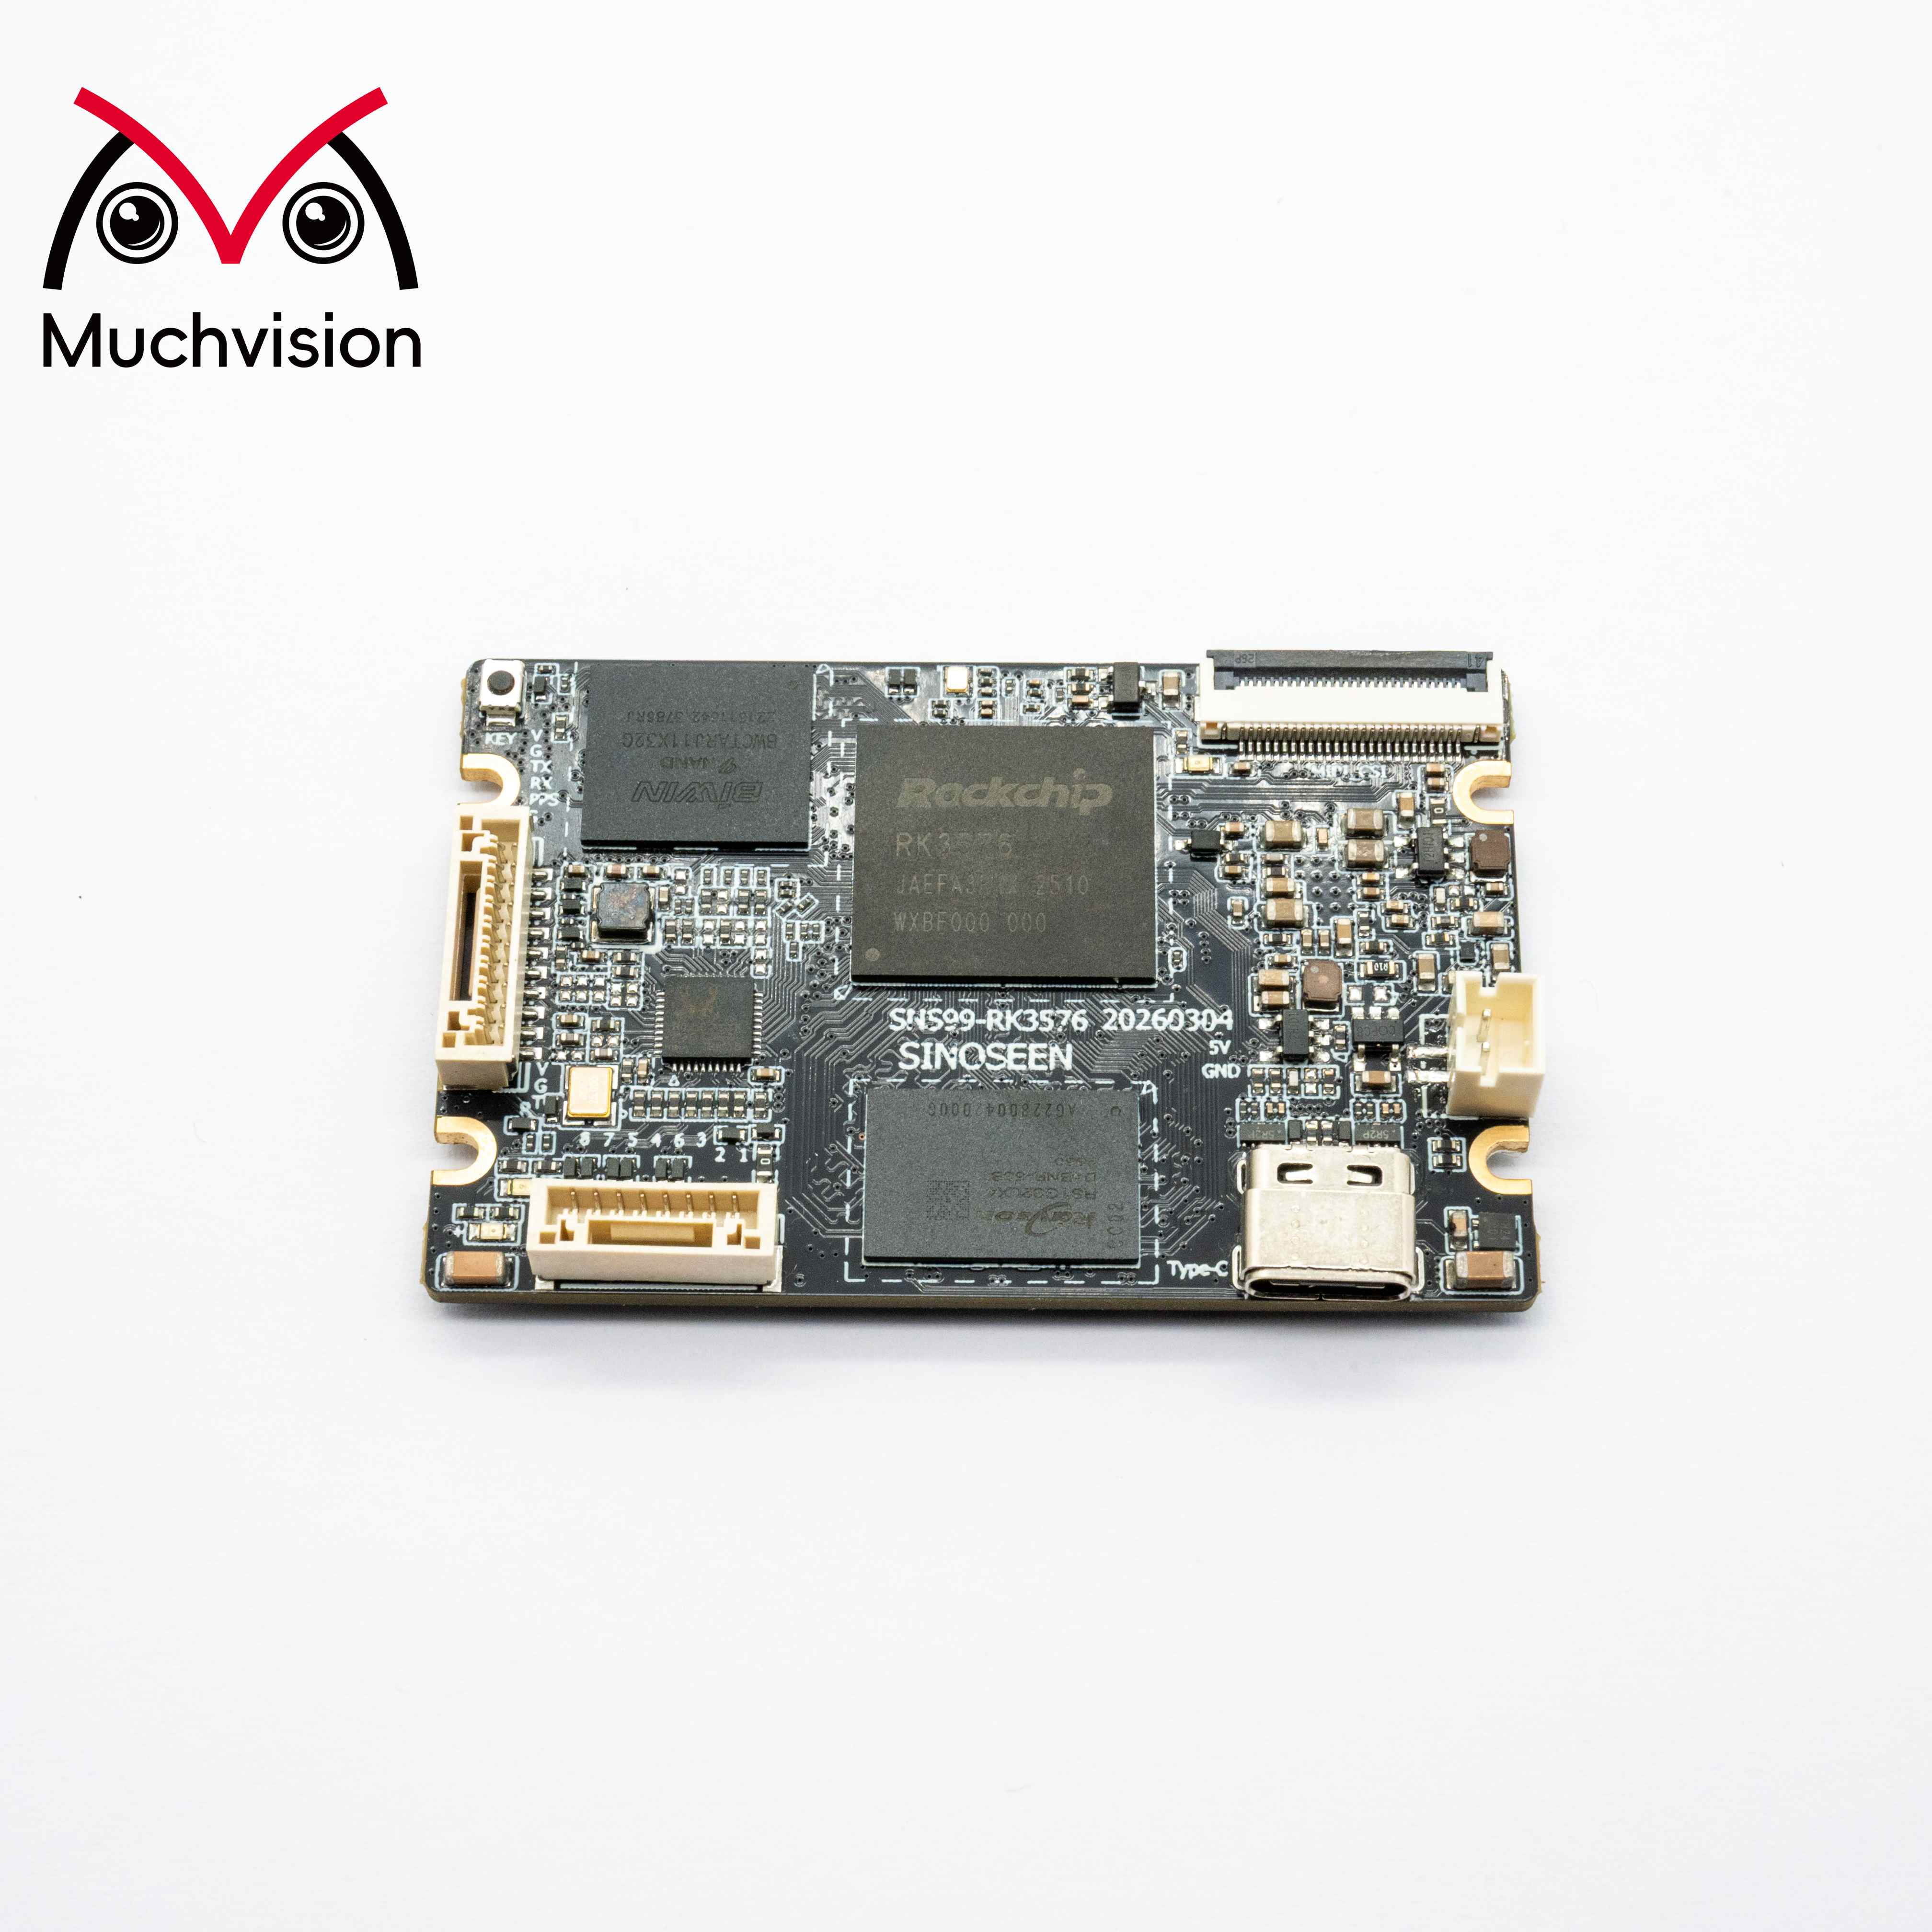
Sprzęt do przetwarzania brzegowego obejmuje od wytrzymałych bram IoT pobierających energię w watach po bezwentylatorowe przemysłowe komputery PC uruchamiające pełne klastry Kubernetes. Dla rozproszonych lokalizacji o umiarkowanym obciążeniu rozwiązania do przetwarzania brzegowego oparte na procesorach ARM lub kompaktowych płytach x86 zapewniają wydajność energetyczną oraz prostotę termiczną kluczową w trudnych środowiskach. Dla intensywnych zadań obliczeniowych lub wnioskowania AI wytrzymałые serwery do przetwarzania brzegowego z dedykowanymi GPU lub akceleratorami neuronowymi zapewniają niezbędną wydajność. Konteneryzacja przy użyciu Docker i Kubernetes umożliwia spójne wdrażanie oprogramowania w heterogenicznej infrastrukturze przetwarzania brzegowego na różnych lokalizacjach, upraszczając aktualizacje i kontrolę wersji.
Wybór oprogramowania do obliczeń brzegowych musi uwzględniać równowagę między bogactwem funkcji a ograniczeniami zasobów. Lekkie dystrybucje systemu Linux oraz minimalne środowiska uruchomieniowe kontenerów pozwalają zachować moc obliczeniową na potrzeby aplikacji. Warto szukać platform do obliczeń brzegowych obsługujących zarówno narzędzia chmurowe, jak i tradycyjne protokoły przemysłowe, aby połączyć istniejące wdrożenia IoT z nowoczesnymi obciążeniami. Twoja strategia obliczeń brzegowych na 2026 rok powinna umożliwiać wdrażanie nowych frameworków sztucznej inteligencji, baz danych w czasie rzeczywistym oraz standardów bezpieczeństwa bez konieczności przebudowy architektury.
Rozproszone miejsca obliczeń brzegowych zwiększają powierzchnię ataku na bezpieczeństwo, co wymaga niezawodnej autentykacji, szyfrowania oraz wykrywania anomalii w każdym węźle. Wdroż autentykację opartą na certyfikatach dla urządzeń obliczeń brzegowych komunikujących się z systemami centralnymi oraz wymuszaj kryptograficzne podpisywanie aktualizacji oprogramowania rozsyłanych do lokalizacji zdalnych. Przechowywanie i przetwarzanie danych poufnych w węzłach obliczeń brzegowych — szczególnie w kontekście przemysłowego Internetu rzeczy (IIoT) — wymaga starannej kontroli dostępu oraz rejestrowania operacji w dziennikach audytu.
Monitorowanie operacyjne wdrożeń obliczeń brzegowych na wielu lokalizacjach wymaga automatyzacji i inteligencji. Centralne tabele kontrolne wyświetlające stan zdrowia, metryki wydajności oraz opóźnienia z każdej rozproszonej lokalizacji umożliwiają szybkie wykrywanie problemów. Rozważ platformy obliczeń brzegowych oferujące inicjowanie bezobsługowe (zero-touch provisioning), automatyczne wykrywanie urządzeń oraz aktualizacje oprogramowania metodą push, aby zminimalizować obciążenie zespołu IT na miejscu. Do 2026 roku należy spodziewać się, że narzędzia do zarządzania obliczeniami brzegowymi będą integrować wykrywanie anomalii sterowane sztuczną inteligencją oraz funkcje samonaprawy, co uczyni rozproszone wdrożenia w dużej skali bardziej zrównoważonymi.
Obliczenia brzegowe zwykle zapewniają opóźnienia na poziomie 1–50 milisekund dla przetwarzania lokalnego, w porównaniu do 50–500+ milisekund dla komunikacji z chmurą. Rzeczywiste opóźnienie zależy od odległości między czujnikami IoT a urządzeniem brzegowym, złożoności przetwarzania oraz jakości sieci. Dobrze zaprojektowane architektury obliczeń brzegowych dla rozproszonych lokalizacji minimalizują zmienność i gwarantują deterministyczne czasy odpowiedzi dla krytycznych obciążeń, dzięki czemu opóźnienie staje się przewidywalne, a nie tylko niskie.
Liczba węzłów zależy od rozkładu geograficznego, gęstości urządzeń IoT, wymagań dotyczących nadmiarowości oraz pożądanego poziomu opóźnień. Praktyczna zasada: umieszczaj obliczenia brzegowe jak najbliżej źródeł danych IoT, aby zminimalizować liczbę przeskoków między czujnikami a urządzeniem brzegowym, a następnie grupuj węzły obliczeń brzegowych regionalnie tam, gdzie pozwalają na to łączność i wydajność administracyjna. Rozpocznij od jednego węzła obliczeń brzegowych na każdą główną lokalizację lub na każde 50–100 urządzeń IoT, a następnie rozbudowuj bazując na zmierzonych wynikach wydajności oraz docelowej dostępności.
Standardy obliczeń brzegowych, przyspieszanie sztucznej inteligencji oraz praktyki zabezpieczania systemów rozwijają się bardzo szybko. Zaprojektuj elastyczność w swojej rozproszonej architekturze lokalizacji, stosując obciążenia kontenerowe, modułowe sprzętowe rozwiązania oraz warstwy zarządzania oparte na interfejsach API. Do 2026 roku wiele organizacji zintegruje duże modele językowe (LLM) oraz rozumowanie AI w czasie rzeczywistym w węzłach obliczeń brzegowych, dlatego upewnij się, że Twoja architektura obsługuje aktualizacje oprogramowania i przyspieszenie przy użyciu GPU bez konieczności fizycznego przeprojektowania.
 Gorące wiadomości
2026-11-06
2026-10-29
2026-10-24
2026-10-23
2026-10-20
2026-10-19

 EN